HOMEデベロッパー向け ブログ・コミュニティ SCSK技術者ブログ OpenShift Loggingを図解で理解|コンテナ環境のログ収集・保存・可視化の仕組み
OpenShift Loggingを図解で理解|コンテナ環境のログ収集・保存・可視化の仕組み
みなさん、こんにちは。今回は、OpenShift上でログを収集・保存・参照するための機能「OpenShift Logging」について、全体の仕組みからじっくり解説していきます。
VMware環境などこれまで仮想マシンをベースに運用してきたインフラエンジニアの方にとって、「ログをどこに置いて、どう見るか」という考え方は、コンテナ環境に移ると大きく変わるポイントの一つです。まずはその違いから見ていきましょう。
対象バージョン:OpenShift Container Platform 4.21 / OpenShift Logging 6.5
1. なぜコンテナ環境ではログ管理の考え方が変わるのか
これまでのサーバ運用では、「サーバ内にログファイルを保存する」のが基本でした。しかしこの方式には、いくつかの手間が伴います。
- サーバごとにSSH接続してログを確認する必要がある
- 複数サーバにまたがる問題を追跡しづらい
- ログのローテーション管理を各サーバで個別に行う必要がある
一方、コンテナ環境ではそもそも前提が異なります。
- Pod はデフォルトでは削除と同時にログも消えてしまう(揮発性)
- Pod 数は動的に増減するため、追跡すべきログの対象が常に変わり続ける
- 1つのアプリが複数の Pod で動作するため、ログが分散する
さらにコンテナのベストプラクティスとして、アプリケーションはログをファイルに書き込むのではなく、標準出力(stdout/stderr)に出力することが推奨されています[1][2]。これは2013年にHerokuが提唱した「The Twelve-Factor App」に由来する考え方で、コンテナ環境全体に浸透している設計思想です。
つまりコンテナ環境では、「個々のサーバにログを残す」のではなく、「揮発する Pod のログを外部でどう一元的に収集・永続化するか」という発想の転換が必要になります。OpenShift Logging は、この課題を解決するための仕組みです。
OpenShift Loggingが提供する価値は次の3点に整理できます。
- 全てのログを一元的に収集・集約する
- ログの永続化(Pod や Node が消えてもログは残る)
- 一元的な検索・可視化インタフェースの提供
2. OpenShift Logging の全体像:3つのレイヤーと3つのOperator
OpenShift Logging 6.x は、役割の異なる3つのレイヤーで構成されています。
| レイヤー | 役割 | 担当Operator |
|---|---|---|
| 収集・転送 | 各ノード上のログを集めて転送する | Red Hat OpenShift Logging Operator |
| 保存・検索 | ログを永続化し、検索可能な状態で保持する | Loki Operator |
| 可視化 | Web コンソール上でログを閲覧できるようにする | Cluster Observability Operator(COO) |
ポイントは、それぞれの層が独立したコンポーネントとして動作し、専用の Operator によって管理されるという点です。OpenShiftクラスタを構築した直後の状態では、これらのOperatorはどれもインストールされていません。ログ機能を使うには、目的に応じて必要なOperatorを個別に導入する必要があります。
大まかな処理の流れはこうです。
- ① 各ノードで動作する Vector(収集エージェント)が、Pod のログやノードのログを収集する
- ② ClusterLogForwarder CR の設定に従って、ログが LokiStack に転送される
- ③ LokiStack はログ本文を圧縮してS3などのオブジェクトストレージに保存し、検索用のインデックスを管理する
- ④ UIPlugin CR を有効化すると、Web コンソール上でログを可視化・検索できるようになる
この一連の設定は、それぞれ ClusterLogForwarder CR(ログ転送設定)、LokiStack CR(Pod の配置先、リソース、Object Storage認証情報など)、UIPlugin CR(Webコンソール上での可視化設定)という3種類のカスタムリソースで管理されます[3]。
3. 収集・転送レイヤー:Vector の役割
ここからは、セクション2で紹介した3つのレイヤーのうち、収集・転送レイヤーを詳しく見ていきます。このレイヤーはRed Hat OpenShift Logging Operatorによって管理されており、Operatorをインストールすると、実際にログ収集を担う Vector という DaemonSet型のエージェントがクラスタにデプロイされます。
役割
- 各ノード上で動作し、そのノード上のすべてのコンテナの stdout/stderr と、ノード自体の journald ログを収集する
- ClusterLogForwarder CR の設定に従って転送先に送る
動作の特徴
- DaemonSet として動作するため、ノードが10台あればVector Podも10個起動する
- 新しい Namespace や Pod が追加されても、Vector の再起動は不要(Kubernetes API を Watch して自動的に収集対象へ加える)
- 収集できるのは stdout/stderr に出力されたログのみ。ファイルに書き込まれたログは収集対象外
Vector が収集するログは、用途に応じて3種類に分類されます。
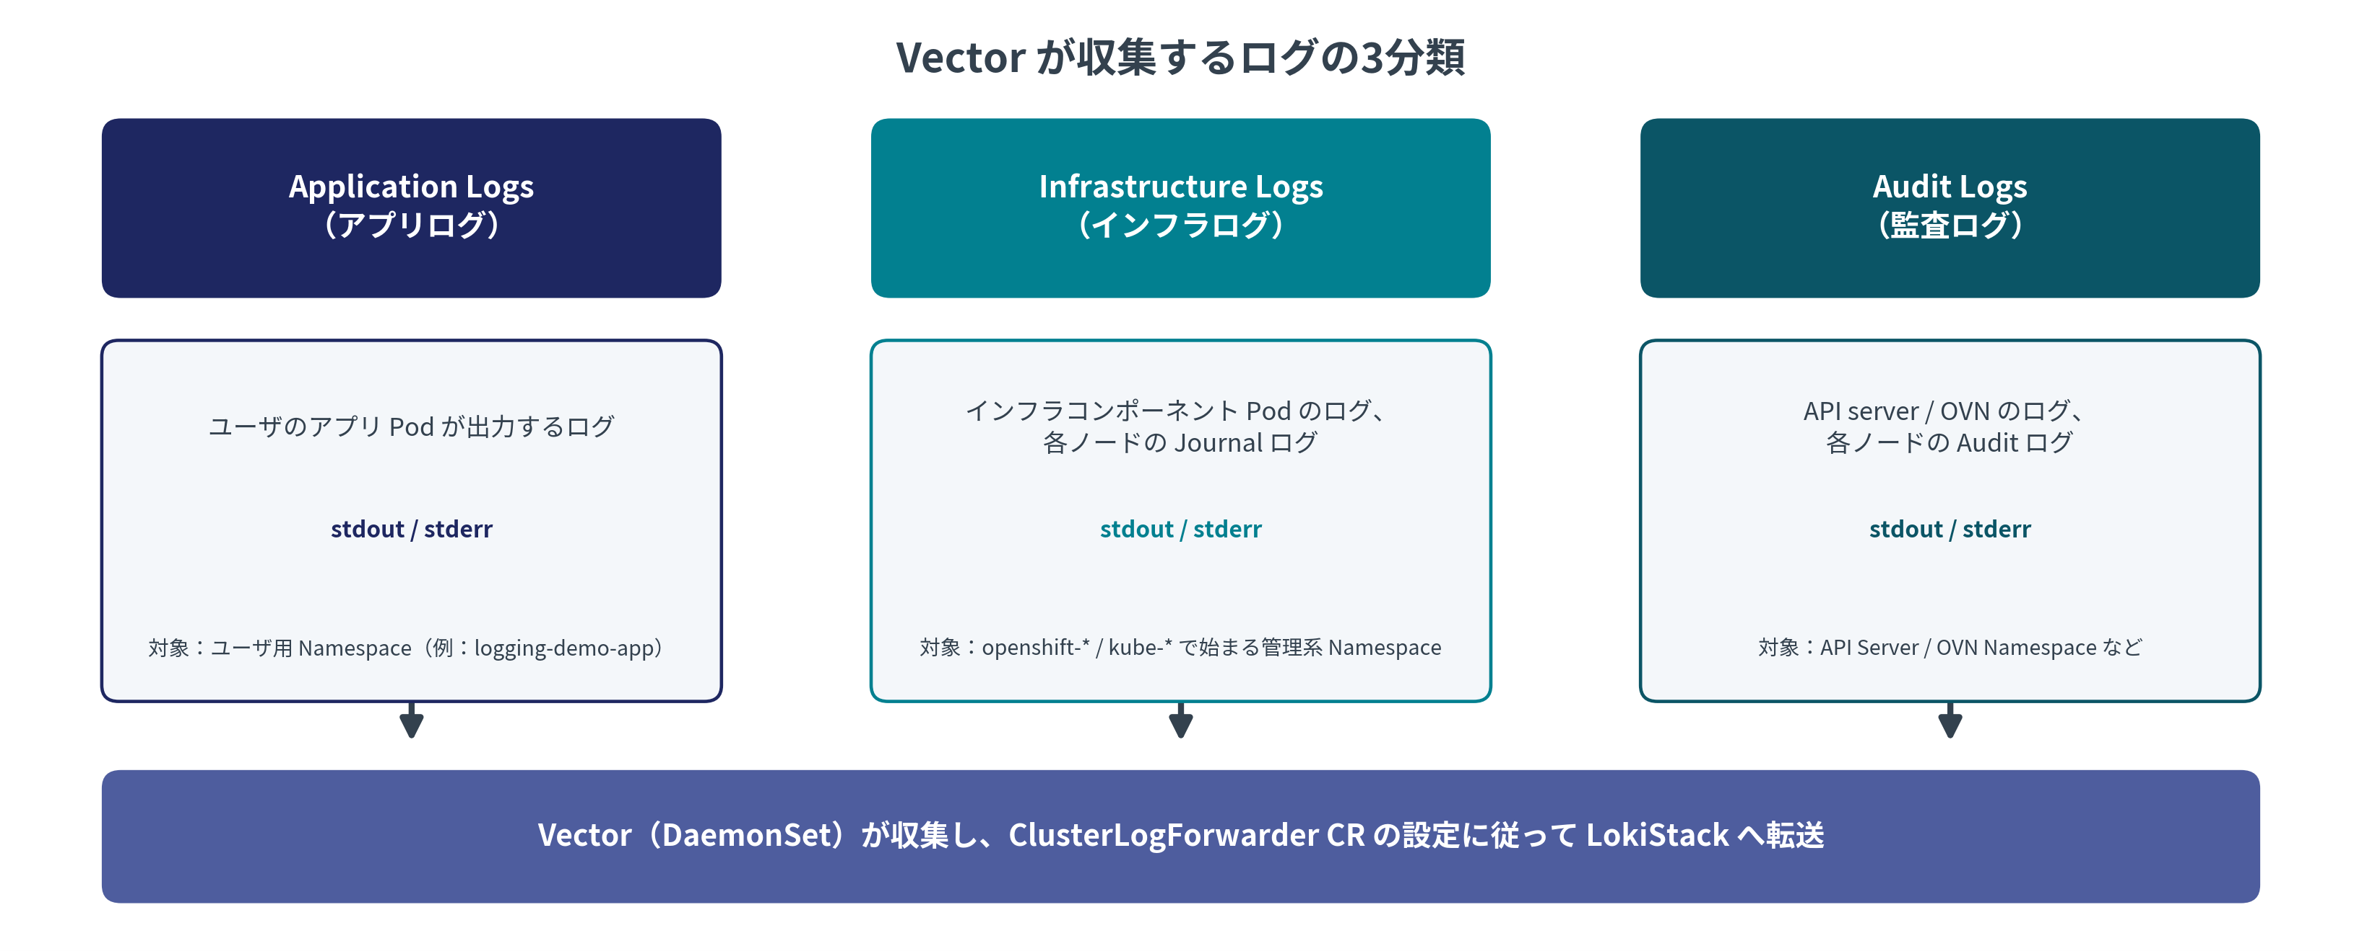
図1:収集されるログの3分類
Audit Logs は出力量が非常に多いため、実運用ではフィルタを設定して使用されるケースが多い点に留意してください[4]。
4. 保存・検索レイヤー:LokiStack のアーキテクチャ
収集されたログの保存と検索を担うのが Loki Operator が管理する LokiStack です。
役割
- ログ本文を「チャンク」と呼ばれるデータブロックに圧縮してS3に保存する
- 検索時はラベル(Namespace名・Pod名など)で対象チャンクを絞り込み、そのチャンク内をgrep的に検索する
設計思想として押さえておきたいポイントは、ログ本文を全文インデックス化するのではなく、ラベルのみをインデックス化している点です。これにより低コストで大量のログを扱えるようになっていますが、その代わり LokiStack は「直近のクエリに最適化された短期ログストア」として設計されており、公式にテスト・サポートされる保持期間の上限は30日です。コンプライアンス対応などで長期保存が必要な場合は、ClusterLogForwarder から Splunk・Elasticsearch・AWS CloudWatch・Kafka などの外部転送先を設定し、そちらで管理することが推奨されています。
LokiStackを構成するコンポーネント
LokiStack は単一のPodではなく、役割の異なる複数のPodの集合体です。書き込み時と読み込み時で経由するコンポーネントが異なります。
- 書き込み時:Gateway → Distributor → Ingester → Block/Object Storage
- 読み込み時:Gateway → Query-Frontend → Querier → Ingester/Object Storage
| コンポーネント | 種別 | 役割 | PVCの有無 |
|---|---|---|---|
| Gateway | 書込・読込 | 外部からのリクエストを受け付け、書き込みはDistributor、読み込みはQuery-frontendへ振り分ける。RBAC認可も担う | なし |
| Distributor | 書込 | Vectorから受信したログストリームをIngesterに振り分ける | なし |
| Ingester | 書込 | 受信したログをメモリバッファに保持し、一定量に達したらチャンクに圧縮してS3へ書き出す | Ingester用PVC WAL専用PVC |
| Query-frontend | 読込 | クエリのキュー管理・分割・並列化・キャッシュを行う | なし |
| Querier | 読込 | LogQLクエリを実際に処理する。Ingester上の最新ログとS3上の過去ログの両方を参照する | なし(Index-Gateway経由でキャッシュPVCを参照) |
| Compactor | 管理 | S3上のインデックスファイルを定期的に結合・最適化する。retention設定時は期限切れチャンクを非同期削除する | 作業用PVC |
| Index-Gateway | 管理 | S3上のインデックスを管理・キャッシュし、クエリを高速化する | インデックスキャッシュPVC |
| Ruler(オプション) | 管理 | Recording rules / Alert rulesを定期評価する | 設定による |
特にIngester周りは少しややこしいので補足します。Ingester はメモリ上にログを一時的にバッファし、チャンクを形成してからS3へまとめてフラッシュします。しかしPodが落ちるとバッファ中のログが消えてしまうため、メモリに書き込むのと同時にWAL(Write-Ahead Log)用PVCにも記録しており、フラッシュが完了するとWAL側のチャンクは削除される仕組みになっています。また、これとは別にIngester用PVCもあり、こちらはメモリ上のバッファをクラッシュから復旧するための回復用ログを保持しています。「Ingester用PVC」と「WAL用PVC」は独立した別々のPVCである点に注意してください。
各コンポーネントのより詳細な説明は、Grafana Loki公式ドキュメントも参照してください[5]。
サイジングの考え方
LokiStack のサイズは、任意のCPU/Memoryを個別指定するのではなく、1x.small のようにあらかじめ用意されたサイズタイプの中から選択する仕様になっています(サイズダウンは非サポート)。
apiVersion: loki.grafana.com/v1
kind: LokiStack
metadata:
  name: logging-loki
  namespace: openshift-logging
spec:
  size: 1x.small
LokiStack CR:サイズ指定の例
主なサイズごとの想定データ転送量・QPS・リソース要件の目安は以下の通りです(詳細はドキュメントを参照)[6]。Replication Factorはどのサイズでも基本的に2(1x.demoのみNone)で差が出にくいため、ここではサイズ間の違いが分かりやすいCPU・メモリ・ディスクの要求量を中心に整理しています。
| Size | Data transfer | QPS(200ms時) | CPU requests | Memory requests | Disk requests |
|---|---|---|---|---|---|
| 1x.demo | Demo use only | Demo use only | None | None | 40Gi |
| 1x.pico(6.1以降) | 50GB/day | 1-25 QPS | 7 vCPUs | 17Gi | 590Gi |
| 1x.extra-small | 100GB/day | 1-25 QPS | 14 vCPUs | 31Gi | 430Gi |
| 1x.small | 500GB/day | 25-50 QPS | 34 vCPUs | 67Gi | 430Gi |
| 1x.medium | 2TB/day | 25-75 QPS | 54 vCPUs | 139Gi | 590Gi |
なお、Rulerコンポーネントを有効化する場合は、上記のCPU・メモリ・ディスク要求量がさらに増加します(例:1x.mediumのCPUは54 vCPUsから70 vCPUsへ増加)。
検証環境であれば 1x.demo や 1x.pico から始めるのがよいでしょう。ちなみにストレージ使用量は環境によって大きく異なり、一般的な指標は存在しませんが、Auditログ収集を有効化した約10台構成の開発環境で1日あたり20GB程度、という例もあります。
導入後は、以下のようなコマンドでLokiStackの状態を確認できます。
$ oc get lokistack logging-loki -n openshift-logging
NAME           READY   AGE
logging-loki   Ready   4m2s
LokiStack のステータス確認コマンド例
5. ログの保持期間はどう設計するか
ログの保持期間管理には、独立した2つの設定方法があり、それぞれ役割が異なります。
- LokiStack CR の retention 設定:Loki(Compactor)が期限切れのチャンクを非同期で物理削除する
- オブジェクトストレージ(S3)側のライフサイクルポリシー:S3が直接オブジェクトを物理削除する
どちらか一方を設定すれば保持期間の管理は可能ですが、両方とも設定しない場合、ログはS3に保存され続ける点に注意してください。

図2:ログ保持期間の管理イメージ(オリジナル作成図)
両方を設定する場合は、同じ日数に揃えることが推奨されています。日数がずれると、以下のような想定外の挙動につながる可能性があります。
- LokiStack側の日数 < S3ライフサイクルの日数 → Lokiではクエリできないが、S3にはデータが残り続ける
- LokiStack側の日数 > S3ライフサイクルの日数 → S3のデータが削除された後もクエリ可能期間が残り、クエリ結果が空になる可能性がある
なお、LokiStack側の retention は「Compactorによるスイーパー」を介した非同期削除のため、設定した日数を多少超えたログが一時的にS3に残ることがある点も覚えておくとよいでしょう。
また、LokiStack CR ではログの種類(application / infrastructure / audit)ごとに保持期間を分けたり、Namespaceの条件によって個別の保持日数を指定したりすることも可能です[7]。
下記の例では、application(アプリログ)のデフォルト保持期間を5日としたうえで、streamsブロックでさらに例外条件を指定しています。selectorにLogQLのラベルセレクタ構文を使い、Namespace名が「test」から始まるログストリームだけを対象に、保持期間を3日へ個別に短縮しています。動作検証用など短期間で消してよいNamespaceにだけ短い保持期間を設定したい場合に有効な書き方です。
spec:
  limits:
    global:
      retention:
        days: 20        # 全テナント共通のデフォルト
    tenants:
      application:
        retention:
          days: 5        # アプリログは5日
          streams:
            - days: 3        # 例外条件は3日
              selector: '{kubernetes_namespace_name=~"test.+"}'
              # "test" から始まる Namespace が対象
      infrastructure:
        retention:
          days: 7        # インフラログは7日
      audit:
        retention:
          days: 10       # 監査ログは10日
LokiStack CR:ログ種別ごとの保持期間設定の例
6. 可視化レイヤー:Cluster Observability Operator(COO)
最後の可視化レイヤーを担うのが Cluster Observability Operator(COO)です。
COOは「ログ機能専用」のOperatorではなく、OpenShiftの可観測性(Observability)機能全般を拡張するための汎用的なOperatorです。実際には、ダッシュボード(Perses)、分散トレーシング、モニタリング、トラブルシューティングパネル(Korrel8r)、そして今回取り上げているログ可視化など、複数のUIPluginを提供しており、スタンドアロンのモニタリングスタックを構築する機能も備えています[8][12]。
今回のログ機能との関係で言えば、COOが提供する複数のUIPluginのうち「logging」用のUIPluginを有効化することで、Webコンソールに「モニタリング > Logs」のログ参照メニューが追加される、という位置付けです。Webコンソールでのログ可視化が不要であれば、UIPlugin(logging)をapplyしなければよいだけで、その場合でもLoki自体は単体でログの収集・保存・クエリ応答が可能です。
注意点として、COOはOpenShiftの特定マイナーリリースに固定されるライフサイクル(Platform Aligned)ではなく、独立した単一のリリースストリームで機能提供される(Rolling Stream)という特徴があります。サポートされた状態を維持するには、新しいバージョンが利用可能になり次第、継続的にアップグレードすることが求められます[9][10]。
COOを導入し UIPlugin CRを作成すると、Webコンソールの「モニタリング > Logs」にログ参照メニューが追加されます。
apiVersion: observability.openshift.io/v1alpha1
kind: UIPlugin
metadata:
  name: logging
spec:
  logging:
    lokiStack:
      name: logging-loki
      namespace: openshift-logging
  type: Logging
UIPlugin CR の設定例
このUIでは、フォームベースの検索・絞り込みに加えて、LogQLクエリを用いた詳細検索も可能です[11]。
7. 誰がどのログを見られるか:アクセス制御の考え方
コンテナ環境ならではの注意点として、Webコンソールからログを参照するには、ログインユーザが対応するロールを持っている必要があるという点が挙げられます。標準の view ロールを持っているだけでは、ログの参照権限は付与されません。
参照させたいログの種類によって、付与すべきクラスタロールとコマンドが異なります。
| 参照させたいログ | クラスタロール名 | コマンド例 |
|---|---|---|
| 特定Namespaceのアプリログ | cluster-logging-application-view | oc adm policy add-role-to-user {ロール名} {ユーザ名} -n {対象namespace} |
| インフラログ | cluster-logging-infrastructure-view | oc adm policy add-cluster-role-to-user {ロール名} {ユーザ名} |
| 監査ログ | cluster-logging-audit-view | oc adm policy add-cluster-role-to-user {ロール名} {ユーザ名} |
たとえば、dev-test という Namespace のアプリログを testuser に参照させたい場合は、次のようなコマンドでロールを付与します。
$ oc policy add-role-to-user cluster-logging-application-view testuser -n dev-test
clusterrole.rbac.authorization.k8s.io/cluster-logging-application-view added: "testuser"
RoleBinding 付与コマンドの例
アプリログはNamespace単位でのRoleBindingとなる一方、インフラログ・監査ログはClusterRoleBindingとなる点が異なりますので、権限設計の際は区別して整理しておくとよいでしょう。ロールを付与していないユーザでWebコンソールにアクセスすると、対象のログは表示されません。
8. 導入までに理解しておきたい準備ステップ
ここまでで全体のアーキテクチャや各レイヤーの役割を見てきましたが、実際に導入する際には、ここまでに登場したLokiStack CR・ClusterLogForwarder CR・UIPlugin CRを作成するだけでは不十分で、その前提となる準備がいくつか必要になります。詳しい手順は次回に譲りますが、概念として押さえておきたい代表的なポイントを2つ紹介します。
① ServiceAccountの作成(Vector用)
Vector(コレクター)がログを収集・転送するには、専用のServiceAccountを作成し、ログの収集(読み取り)権限と転送(書き込み)権限を持つClusterRoleを紐付けておく必要があります。ClusterLogForwarder CRの spec.serviceAccount にはこのServiceAccountを指定します。この権限設定がないと、CRを作成してもVectorはログを収集・転送できません。
② Secretの作成(オブジェクトストレージ接続用)
LokiStackがS3などのオブジェクトストレージに接続するには、バケット名・リージョン・認証情報などを格納したSecretをあらかじめ作成し、LokiStack CRの spec.storage.secret から参照させる必要があります。認証方式にはアクセスキーを使う方式と、STS(IAMロール)を使う方式があり、ROSAなどSTSを利用する環境では、AWS側でのIAMロール作成も別途必要になります。
つまり導入の全体像としては、「ServiceAccount・Secretなどの前提リソースを準備する」→「LokiStack CR・ClusterLogForwarder CR・UIPlugin CRを作成する」→「RBACでアクセス権限を設計する」という順序で進めていくことになります。
まとめ
OpenShift Loggingは、「収集・転送」「保存・検索」「可視化」という3つの独立したレイヤーが、それぞれ専用のOperator(Red Hat OpenShift Logging Operator / Loki Operator / Cluster Observability Operator)によって管理される構成になっています。
コンテナ環境では、Pod削除とともにログが消える揮発性という前提の変化があるからこそ、こうした一元的な収集・永続化・可視化の仕組みが重要になります。まずは全体のアーキテクチャと各コンポーネントの役割を押さえたうえで、自環境のログ量や保持要件に応じて、LokiStackのサイジングや保持期間、アクセス権限を設計していくのがよいでしょう。
次回は、ここで触れたServiceAccountやSecretの作成を含め、各Operatorの導入からログ出力確認までの具体的な構築手順を実践編として取り上げる予定です。
参考文献
[1] モダンなアプリをSaaSで提供するための方法論として、Herokuが2013年に提唱。https://blog.heroku.com/twelve-factor-apps
[2] https://www.redhat.com/architect/12-factor-app
[3] https://docs.redhat.com/en/documentation/openshift_container_platform/4.20/html-single/logging/index
[4] https://docs.redhat.com/ja/documentation/red_hat_openshift_logging/6.5/html-single/configuring_logging/index#logging-audit-log-filtering_configuring-log-forwarding
[5] https://grafana.com/docs/loki/latest/get-started/components/
[6] https://docs.redhat.com/ja/documentation/red_hat_openshift_logging/6.5/html-single/configuring_logging/index#loki-sizing_configuring-the-log-store
[7] https://docs.redhat.com/ja/documentation/red_hat_openshift_logging/6.5/html-single/configuring_logging/index#logging-loki-retention_configuring-the-log-store
[8] https://docs.redhat.com/en/documentation/red_hat_openshift_cluster_observability_operator/1-latest/html-single/about_red_hat_openshift_cluster_observability_operator/index
[9] https://access.redhat.com/support/policy/updates/openshift_operators
[10] https://access.redhat.com/labs/ocpouic/?operator=cluster-observability-operator&&upgrade_path=4.20%20to%204.21
[11] https://grafana.com/docs/loki/latest/query/query_examples
[12] https://docs.redhat.com/en/documentation/red_hat_openshift_cluster_observability_operator/1-latest/html-single/ui_plugins_for_red_hat_openshift_cluster_observability_operator/index