
2026.10.02


目次
皆様、こんにちは。
「Hybrid Cloud di」のKafka技術を担当しております、上村です。
前回の記事では、データベースの変更をリアルタイムに捉える技術としてCDC(Change Data Capture)とDebeziumをご紹介しました。今回はその続編として、Kafkaのエコシステムの中でも近年特に話題に上がることの多い「Apache Flink」、そしてそれをフルマネージドで提供する「Confluent」に着目してお届けします。
KafkaとCDCで実現できるのは、あくまで「データが発生した瞬間に、必要な場所へ届ける」ところまでです。しかし実際のビジネスで価値が生まれるのは、届いたデータをその場で処理し、アクションにつなげた瞬間です。本記事ではこの部分を「考える」と呼びます。具体的には、流れてくるデータに対する集計・変換・結合・条件判定といった処理のことで、これを担うのがApache Flinkです。
本記事では、Flinkの基本的な仕組みから、Confluent上で動かすことで得られる相乗効果、具体的なユースケースまでを整理してご紹介します。生成AIの活用が広がるなかで、「AIに渡すデータをいかに最新に保つか」という観点からもFlinkは注目されています。後半ではRAG基盤への応用も取り上げます。
Kafkaを導入すると、これまで日次バッチで受け渡していたデータが、秒単位で流れてくるようになります。ここで多くの現場が次の壁にぶつかります。
これらに共通するのは、処理を連携先まで持ち越している点です。連携基盤が運ぶだけで終わると、連携先には生データが全件届き、そこで溜めてから集計することになります。ここで発想を変えて、溜める前に、流れたまま考える。これがストリーム処理という考え方です。
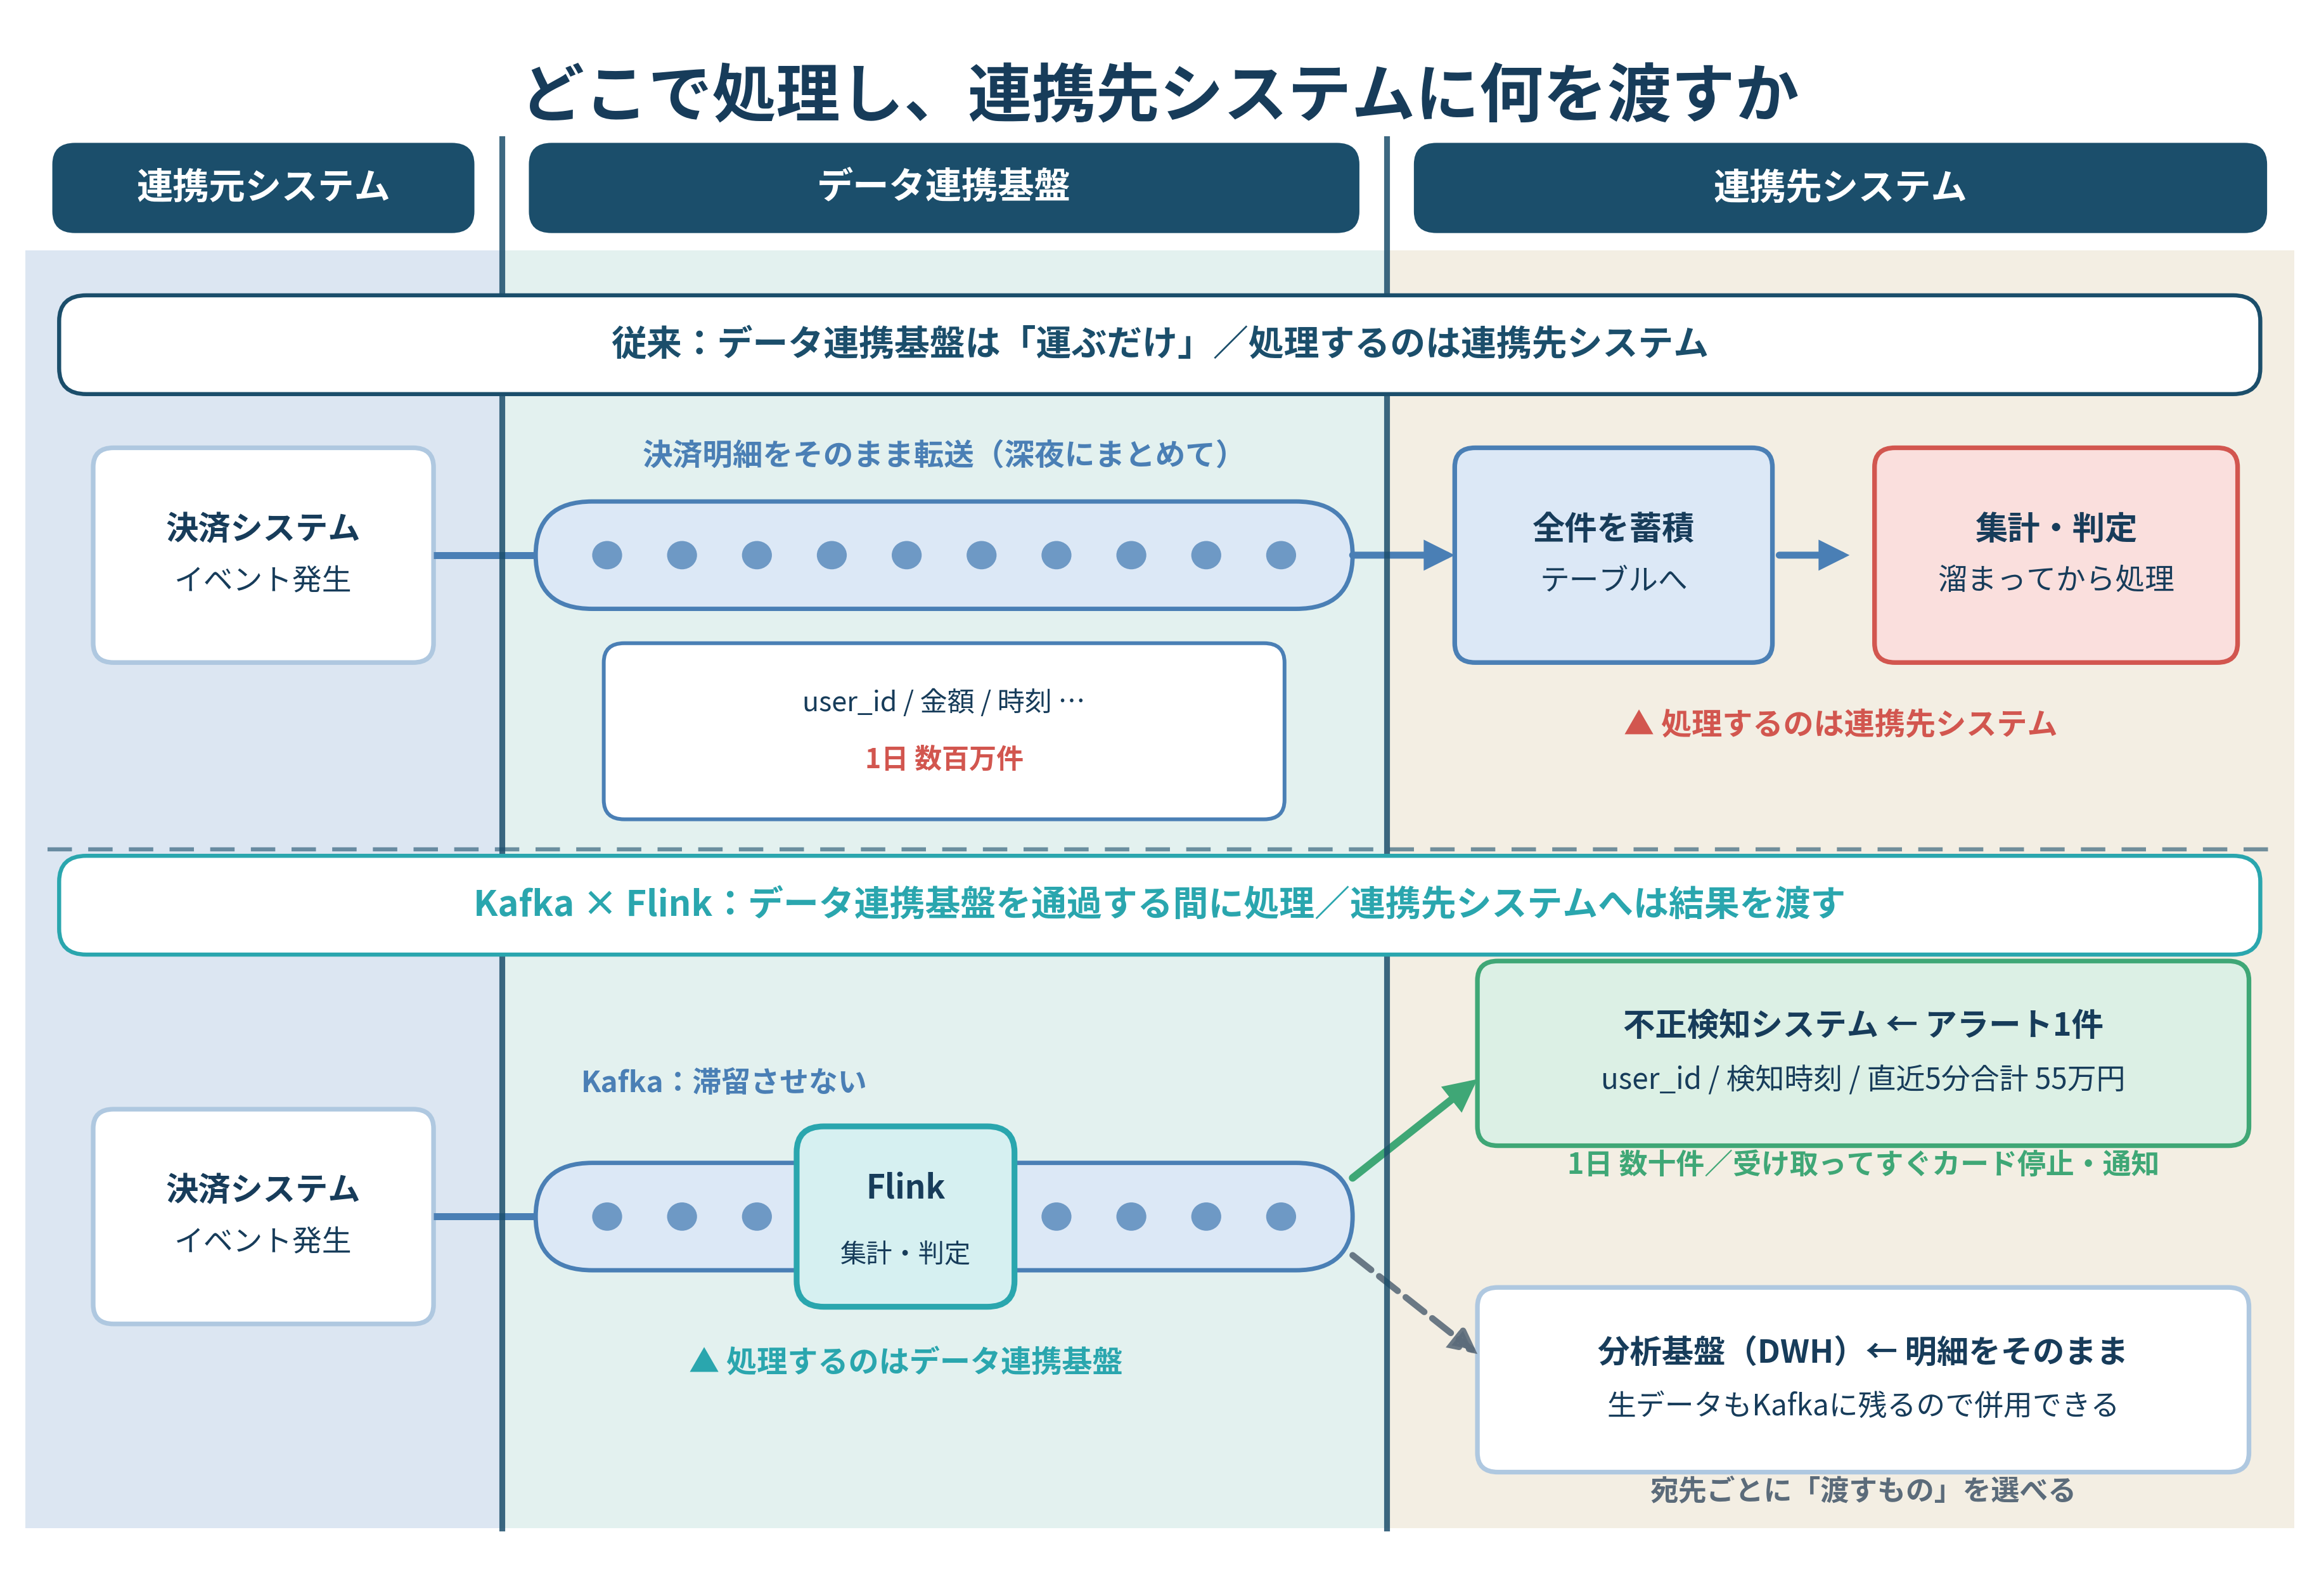
図1:どこで処理し、連携先システムに何を渡すか
Kafkaがデータを「運ぶ」役割を担い、その流れの途中で計算を行うのがApache Flinkの役割です。ここで押さえておきたいのは、Kafkaもデータを永続的に保持するものの、溜まるのを待ってから処理するわけではない、という点です。イベントは到着した端から通過し、その通過中にFlinkが集計・判定を済ませます。
この違いは、連携先に届くデータそのものにも表れます。従来は決済明細が1日数百万件そのまま渡されるため、連携先は「まだ意味を持たないデータの山」を受け取り、自分で集計して初めて判断できる状態になります。一方Kafka × Flinkでは、通過する間に集計・判定が終わっているため、連携先が受け取るのは1日数十件のアラートだけです。中身はuser_id・検知時刻・直近5分間の合計金額といった処理済みの結果で、連携先はカードの停止や本人への通知といったアクションを実行するだけで済みます。なお生データはKafka上に残るため、不正検知システムへはアラートだけ、分析基盤へは明細もそのまま、というように宛先ごとに渡すものを選べます。
Apache Flinkは、終わりのない(Unbounded)データストリームを、低遅延かつ高スループットで処理するための分散処理エンジンです。Kafkaと同じくApache Software Foundationのトップレベルプロジェクトであり、ストリーム処理の分野では事実上の標準となりつつあります。
Flinkの強みは、大きく次の4つに整理できます。
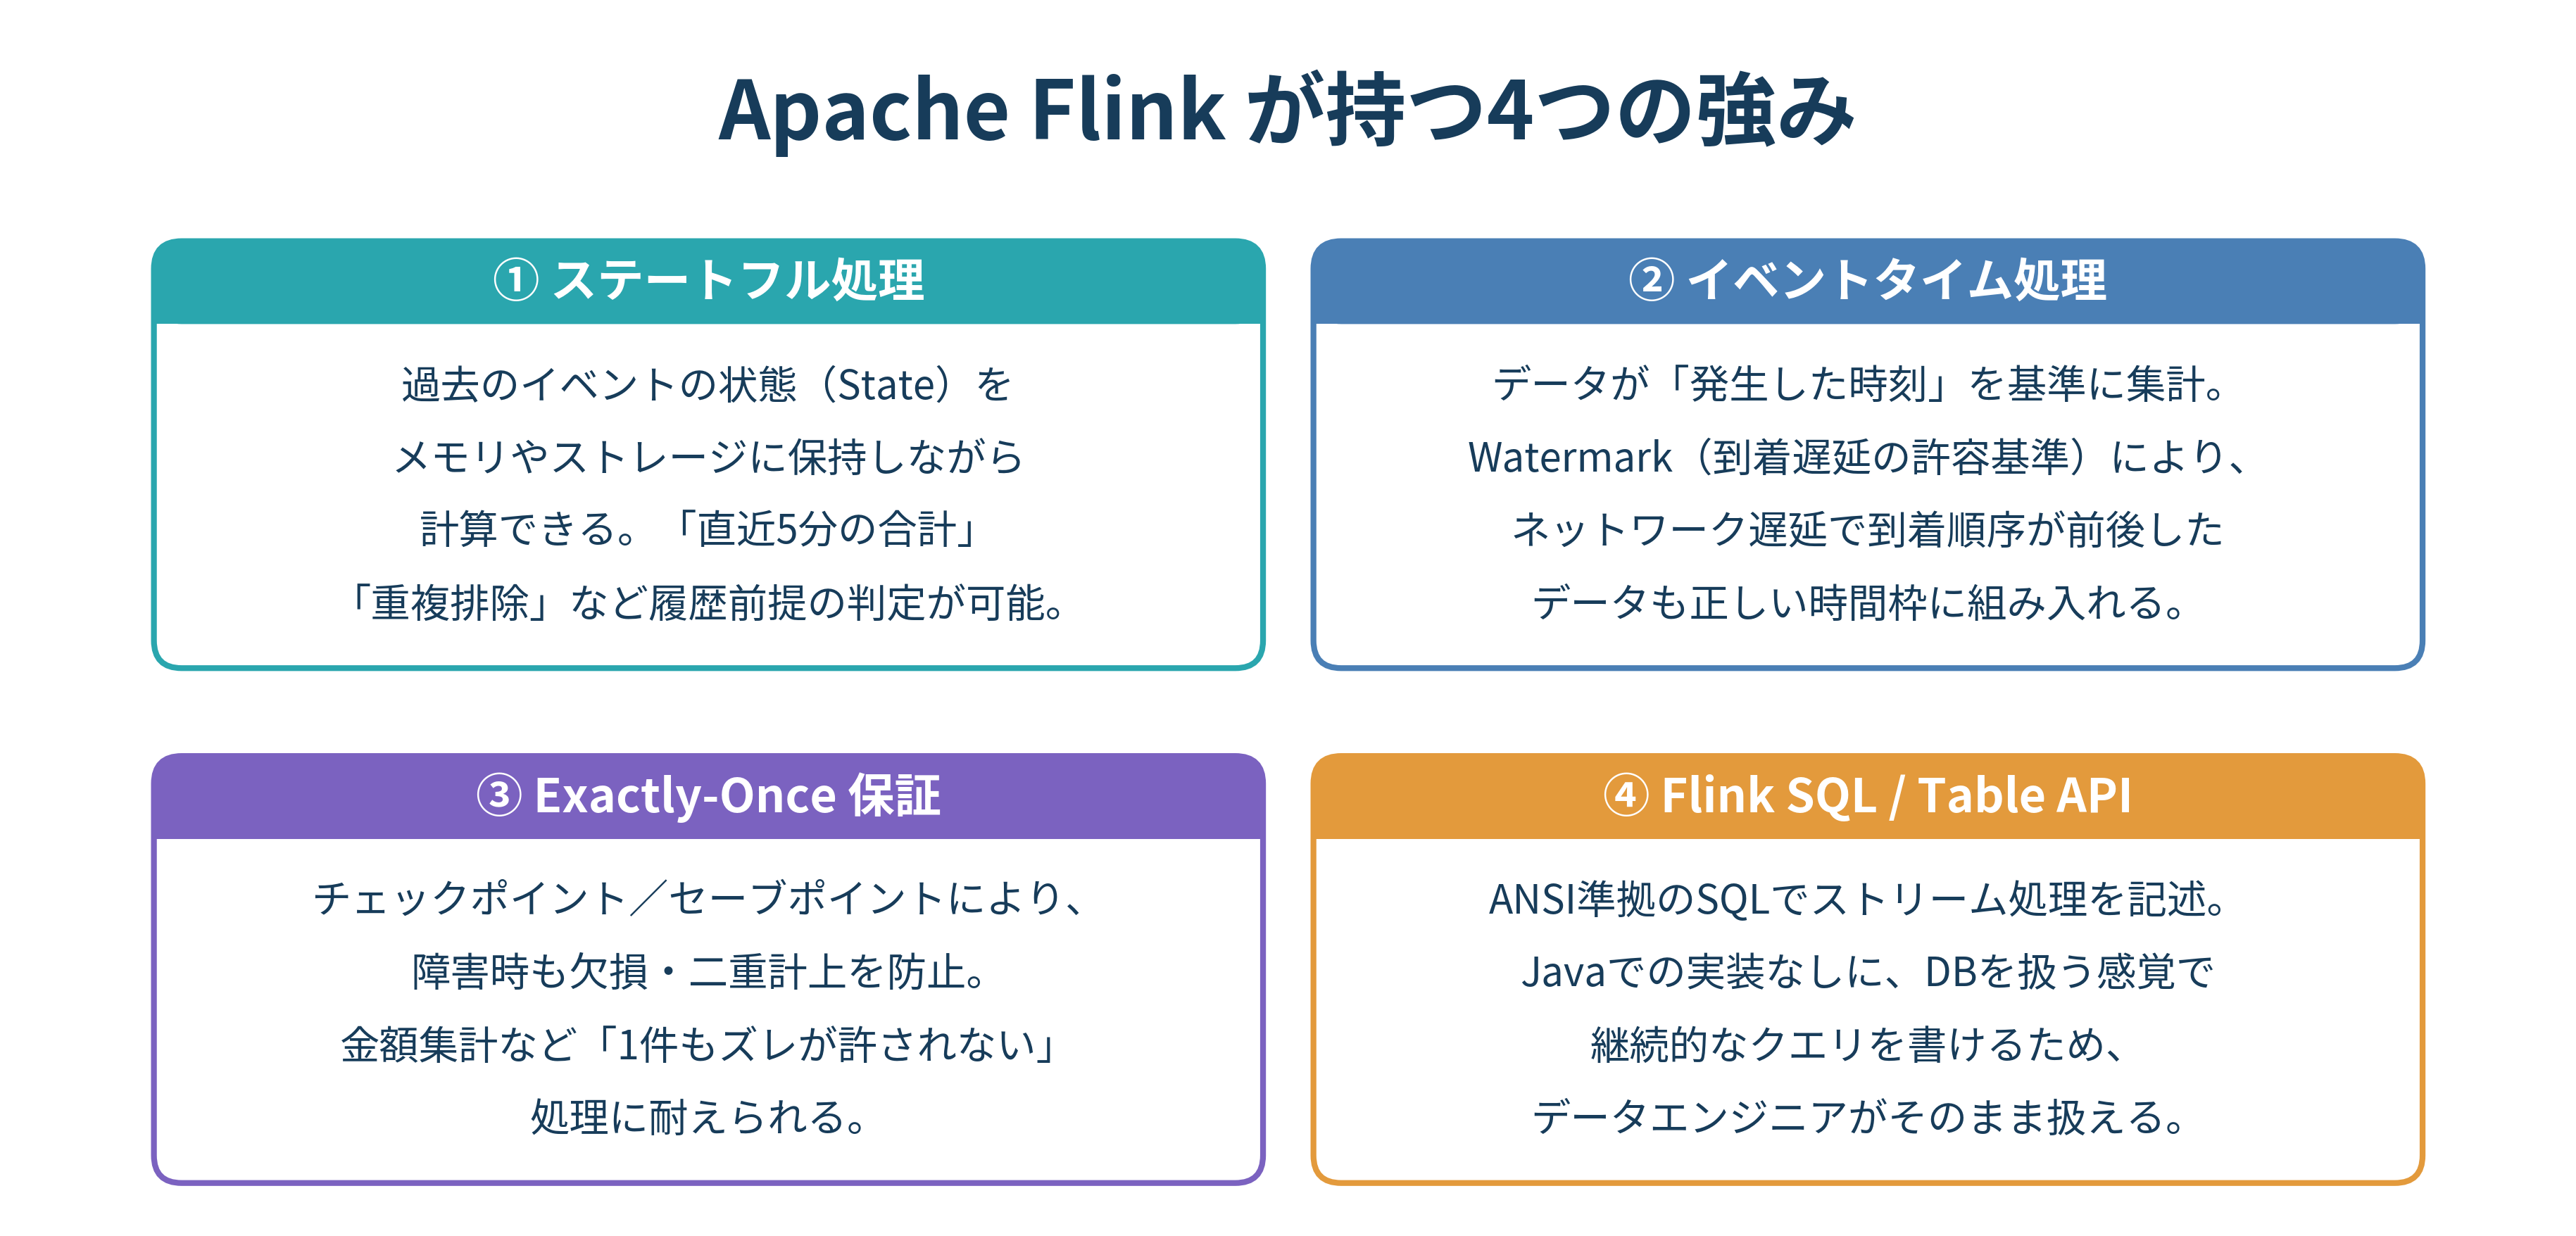
図2:Apache Flinkが持つ4つの強み
補足:Flinkのウィンドウは「発生時刻」を基準にするため、遅れて到着したデータの扱い(どこまで待つか)を設計する必要があります。ここがバッチ処理との一番大きな考え方の違いであり、PoCの段階で必ず確認しておきたいポイントでもあります。
Flink自体はOSSであり、自前で構築することもできます。ただし実運用を考えると、クラスタのプロビジョニング、ステート(状態)のバックアップ、バージョンアップ、スキーマ変更への追従など、決して小さくない運用負荷が発生します。
Confluent Platform / Confluent Cloud上でFlinkを利用すると、Kafkaエコシステムの構成要素と組み合わさることで、次のような相乗効果が生まれます。
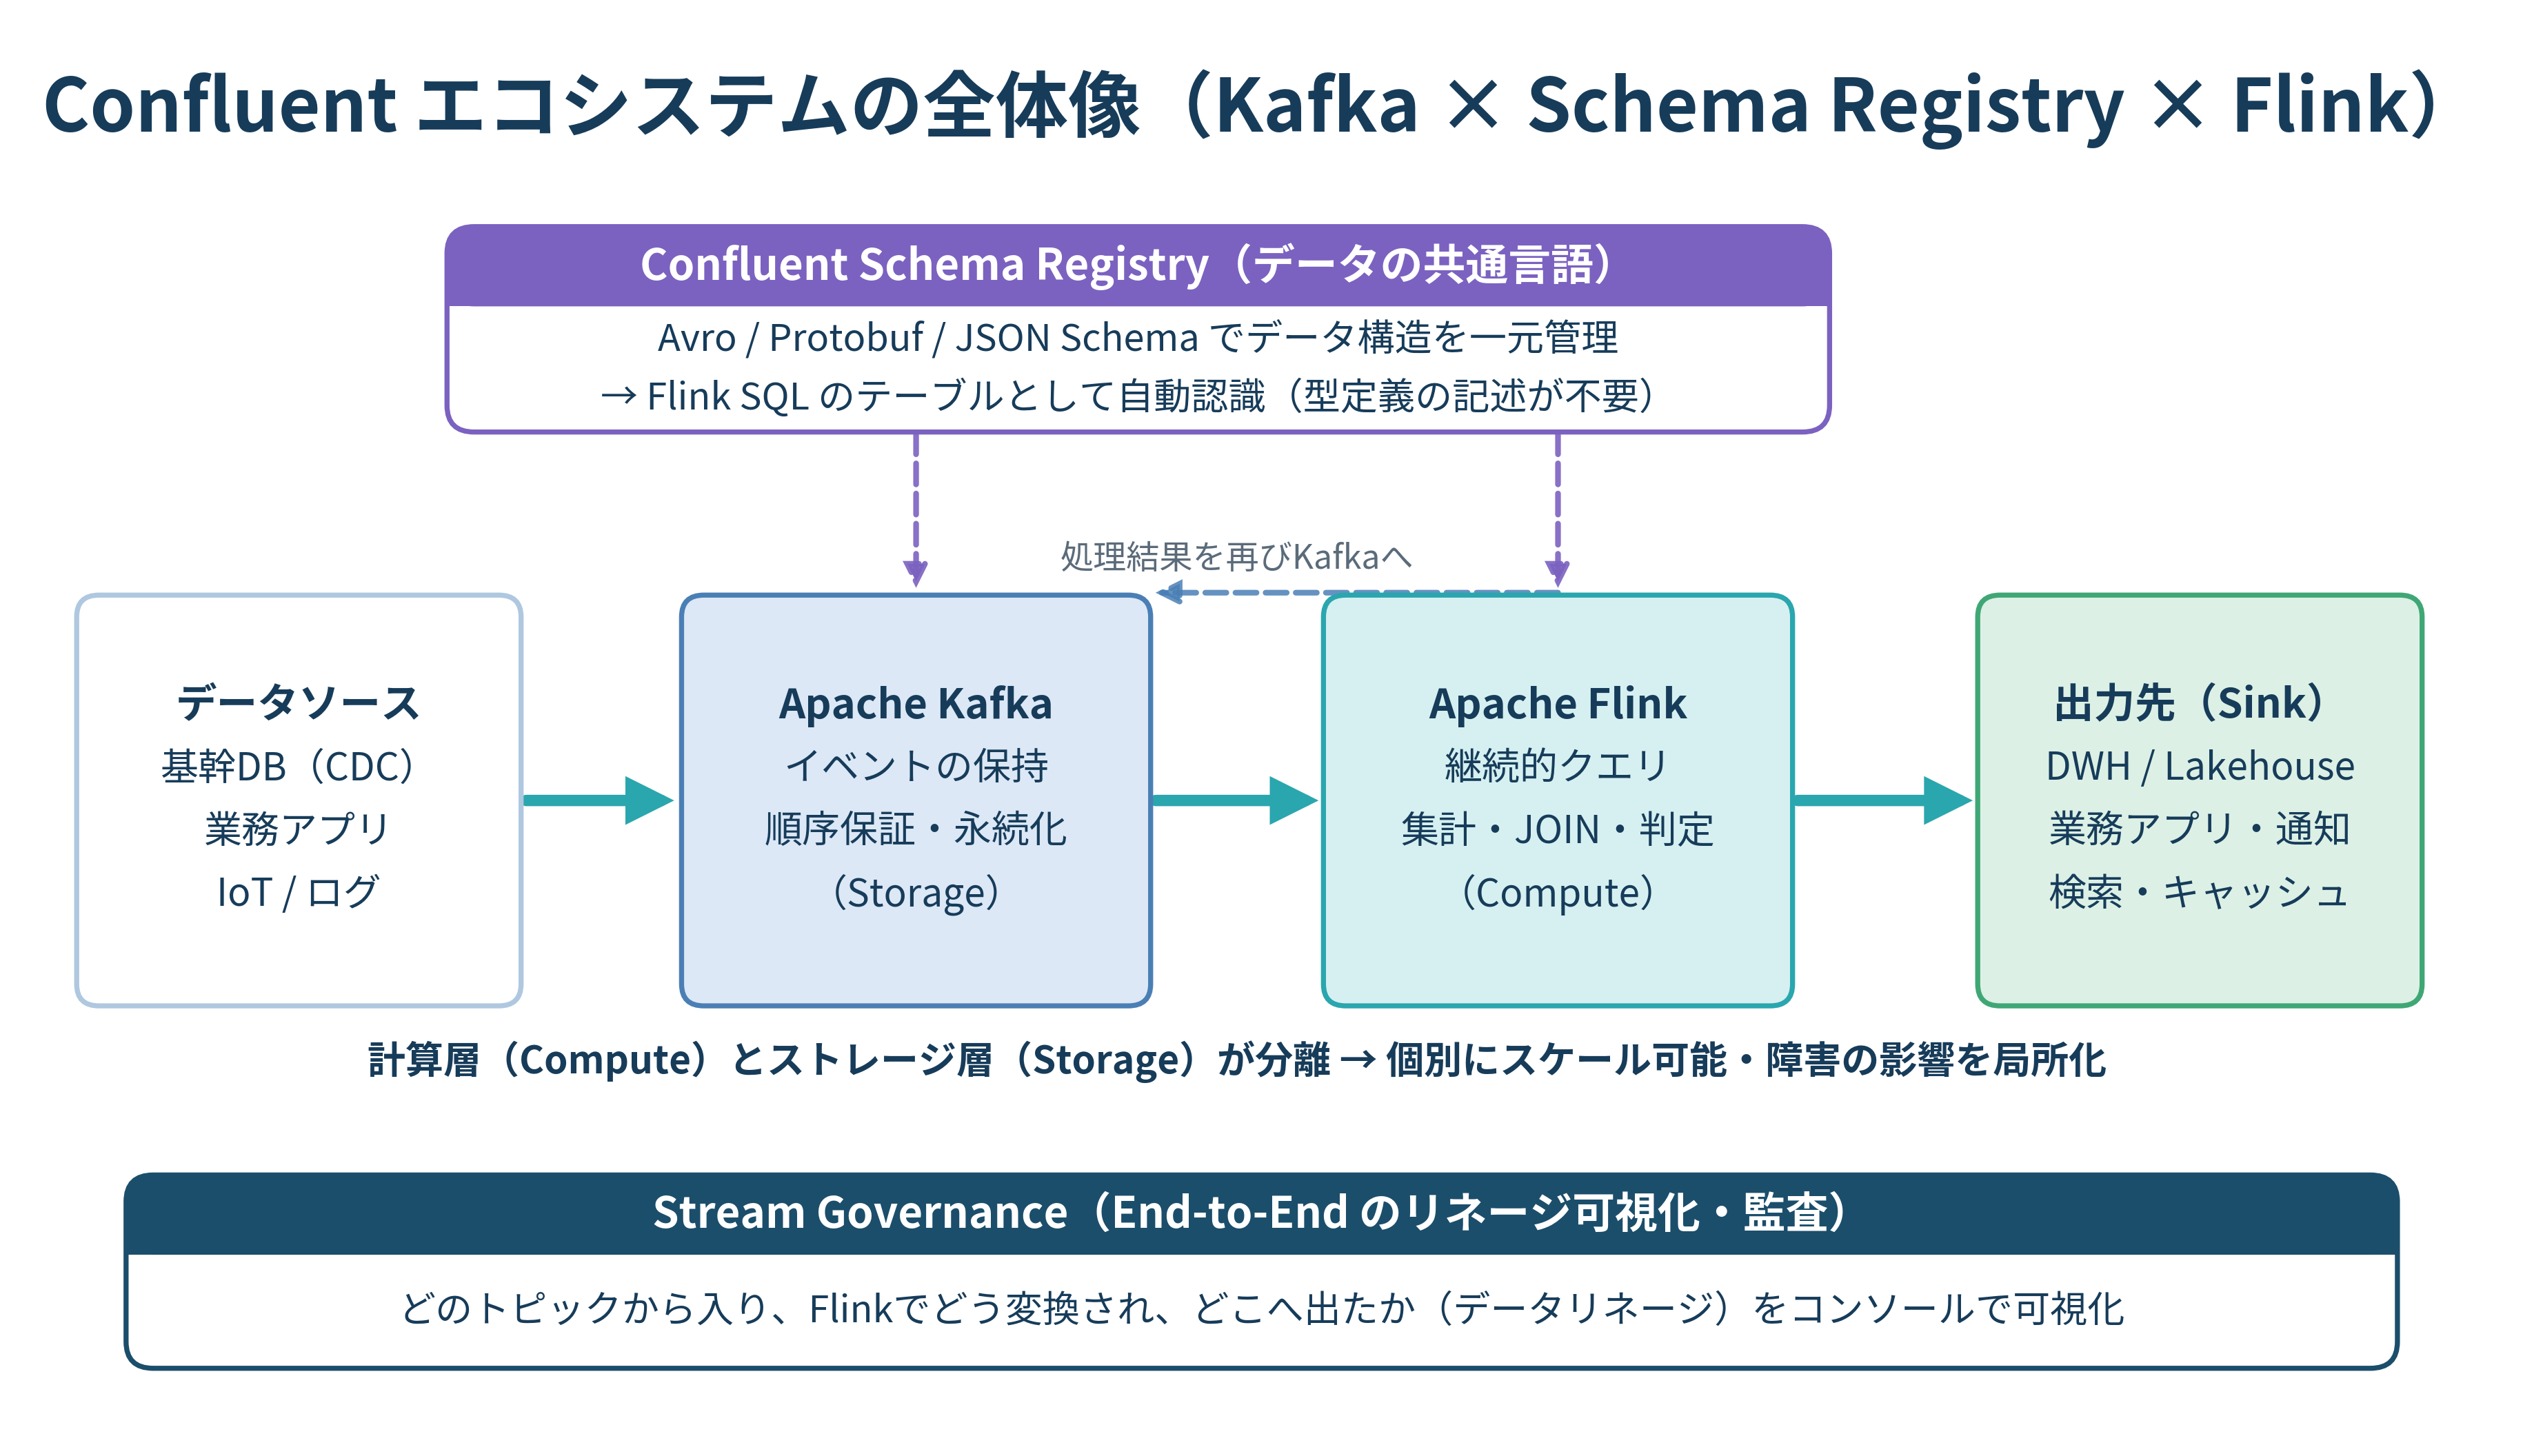
図3:Confluentエコシステムの全体像(Kafka × Schema Registry × Flink)
Kafkaが「順序性を保証したイベントの永続的な保持(Storage)」を担い、Flinkが「データに対する継続的なクエリ(Compute)」を担います。計算層とストレージ層が分離されているため、処理が重い時間帯はFlink側だけをスケールさせる、といった柔軟な運用が可能になります。障害時もKafkaにデータが残っているため、Flink側を再開すれば取りこぼしなく処理を再開できます。
Schema Registry(Avro / Protobuf / JSON Schema)とFlinkがネイティブに連携します。
Kafka ConnectのCDCコネクタと組み合わせる場合、DBのテーブル定義がそのままSchema Registryに登録され、Flink SQLからテーブルとして扱える、という流れになります。ConfluentはマネージドなDebeziumベースコネクタやOracle CDCなどの高機能コネクタを提供しているため、既存DBの種類に応じて選択できます。CDCとストリーム処理が自然につながる点は、Confluentを選ぶ大きな理由のひとつです。
オートスケーリングにより、データ量が急増した場合も処理リソースが自動調整されます。インフラのパッチ適用やチェックポイント用ストレージの管理にリソースを割く必要がなく、開発者はビジネスロジック(SQL)の記述に集中できます。
「どのトピックから入ったデータが、Flinkでどう変換され、どのトピックへ出力されたか」というデータの流れ(データリネージ)をコンソール上で視覚的に把握できます。障害発生時の影響範囲の特定や、セキュリティ監査への対応が容易になります。
実際の画面イメージが図4です。コネクタ → トピック → Flinkステートメント → 出力トピック、という流れがグラフとして自動的に描画され、どのFlink処理がどのトピックを読み書きしているかがひと目で分かります。パイプラインが増えてきたときに、この可視化があるかないかで運用のしやすさが大きく変わります。
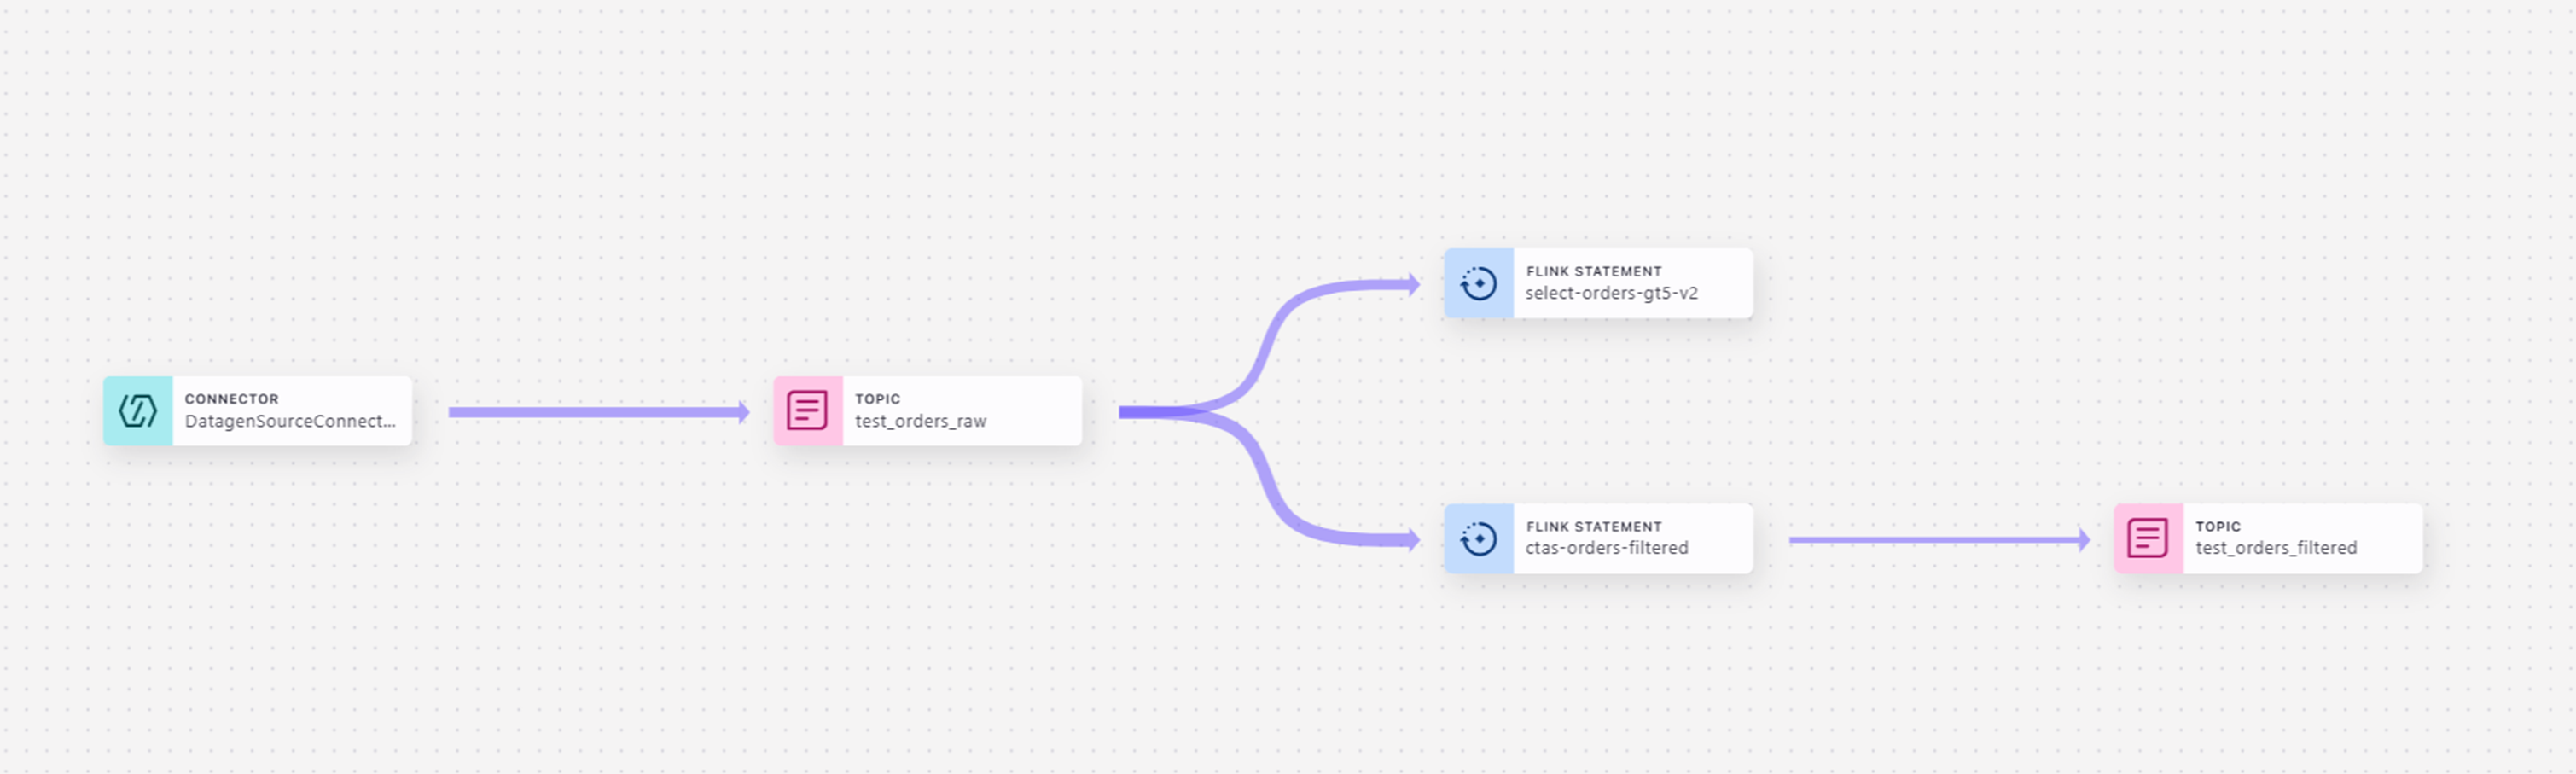
図4:Stream Lineageの画面 ― コネクタからFlink処理、出力トピックまでの流れが自動で可視化される
Confluent × Flinkが特に効果を発揮する、代表的な3つのユースケースをご紹介します。①リアルタイム不正検知、②リアルタイムETL、③生成AI・機械学習との連携の3つで、前半2つは従来からのストリーム処理の王道、最後の1つは近年急速に注目が高まっている領域です。
クレジットカード決済や不審なログイン試行は、数日後のバッチで検出しても被害を防げません。Flinkであれば、「同一アカウントから5分以内に離れた地点で決済された」「直近1分間に高額決済が集中している」といったパターンを、ウィンドウ処理とステート管理で即座に検知できます。
たとえば「決済が届くたびに、そのユーザーの直近5分間の合計金額を計算し、しきい値を超えたら検知する」処理は、Flink SQLで次のように記述できます。
-- 決済イベントが届くたびに、そのユーザーの「直近5分間」の合計を計算し、
-- 50万円を超えた瞬間に検知する
SELECT user_id, event_time, amount, total_5min
FROM (
SELECT
	user_id,
	event_time,
	amount,
	SUM(amount) OVER (
		PARTITION BY user_id
		ORDER BY event_time
		RANGE BETWEEN INTERVAL '5' MINUTE PRECEDING AND CURRENT ROW
	) AS total_5min
FROM transactions        -- Kafkaトピックをテーブルとして参照
)
WHERE total_5min > 500000;
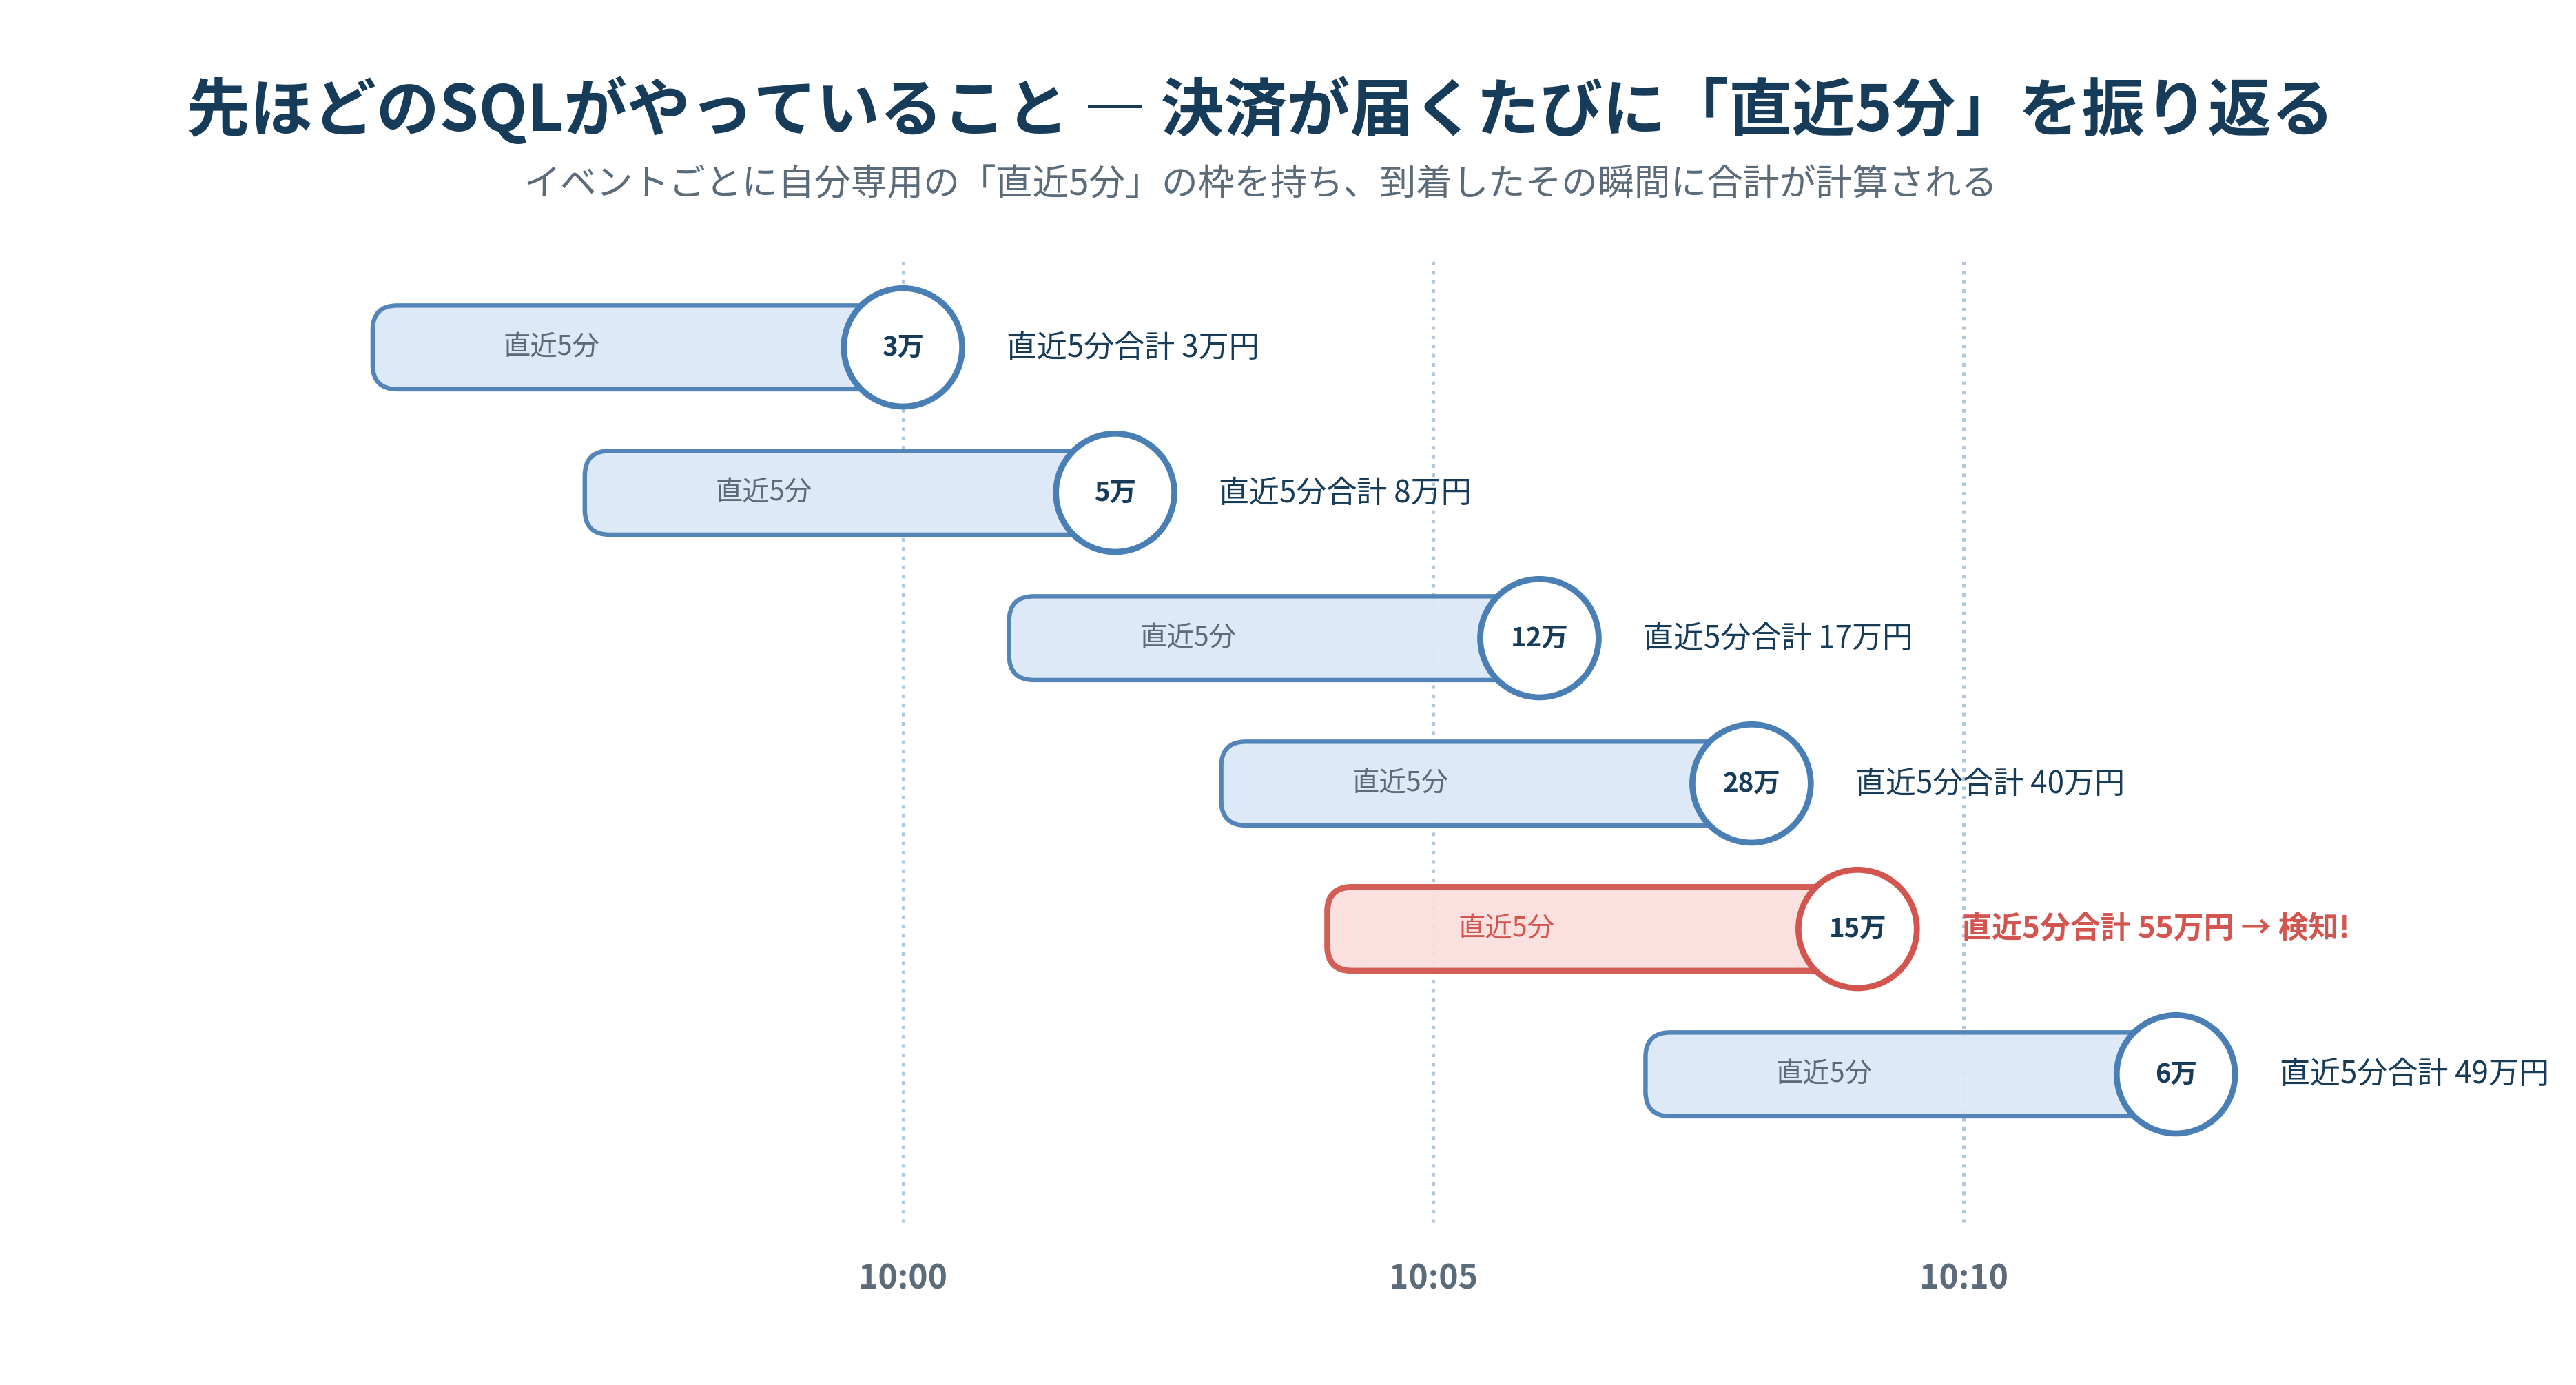
図5:決済が届くたびに、そのイベントから遡って「直近5分」が集計される
ポイントは2つあります。1つ目は、このSQLが「一度実行して終わり」ではなく、ジョブとして常駐し続け、イベントが届くたびに判定を行うという点です。2つ目は、検知がイベント到着のその瞬間に行われることです。図5のとおり、各イベントが自分を終端とする「直近5分」の枠を持つため、55万円に達した10:09の決済そのものをトリガーに、その場でブロックやアラートを実行できます。
なお、この「直近の状態を保持しながら閾値を判定する」パターンは決済に限りません。製造業でのセンサ値の異常検知(予兆保全)、ログイン試行の監視、SLA違反の検出など、「待てない判定」全般にそのまま応用できます。
補足:時間帯別レポートのように「5分ごと」「1時間ごと」と固定の枠で区切って集計したい場合は、TUMBLE(タンブリングウィンドウ)や、枠をずらしながら重ねるHOP(ホップウィンドウ)を使います。即時検知はOVER集計、定期集計はウィンドウ集計、という使い分けが定石です。
マイクロサービスごとに分断されたデータベースの変更(CDC)を結合し、最新の状態を保ったまま分析基盤へ送りたい、というニーズは年々高まっています。Kafka ConnectのCDCコネクタで収集したKafka上の複数トピック(顧客情報、注文情報、商品情報など)をFlinkでJOIN・エンリッチメント(データ拡充)し、Apache IcebergやSnowflake、Databricksといった分析基盤へストリーミング書き込みします。
注文イベントに商品マスタの「その時点の単価」を結合する場合は、次のような書き方になります。
-- 注文が発生した時点の商品マスタ(単価)を結合してエンリッチ
SELECT
	o.order_id,
	o.quantity,
	p.unit_price,
	o.quantity * p.unit_price AS order_amount
FROM orders AS o
LEFT JOIN products FOR SYSTEM_TIME AS OF o.order_time AS p
	ON o.product_id = p.product_id;
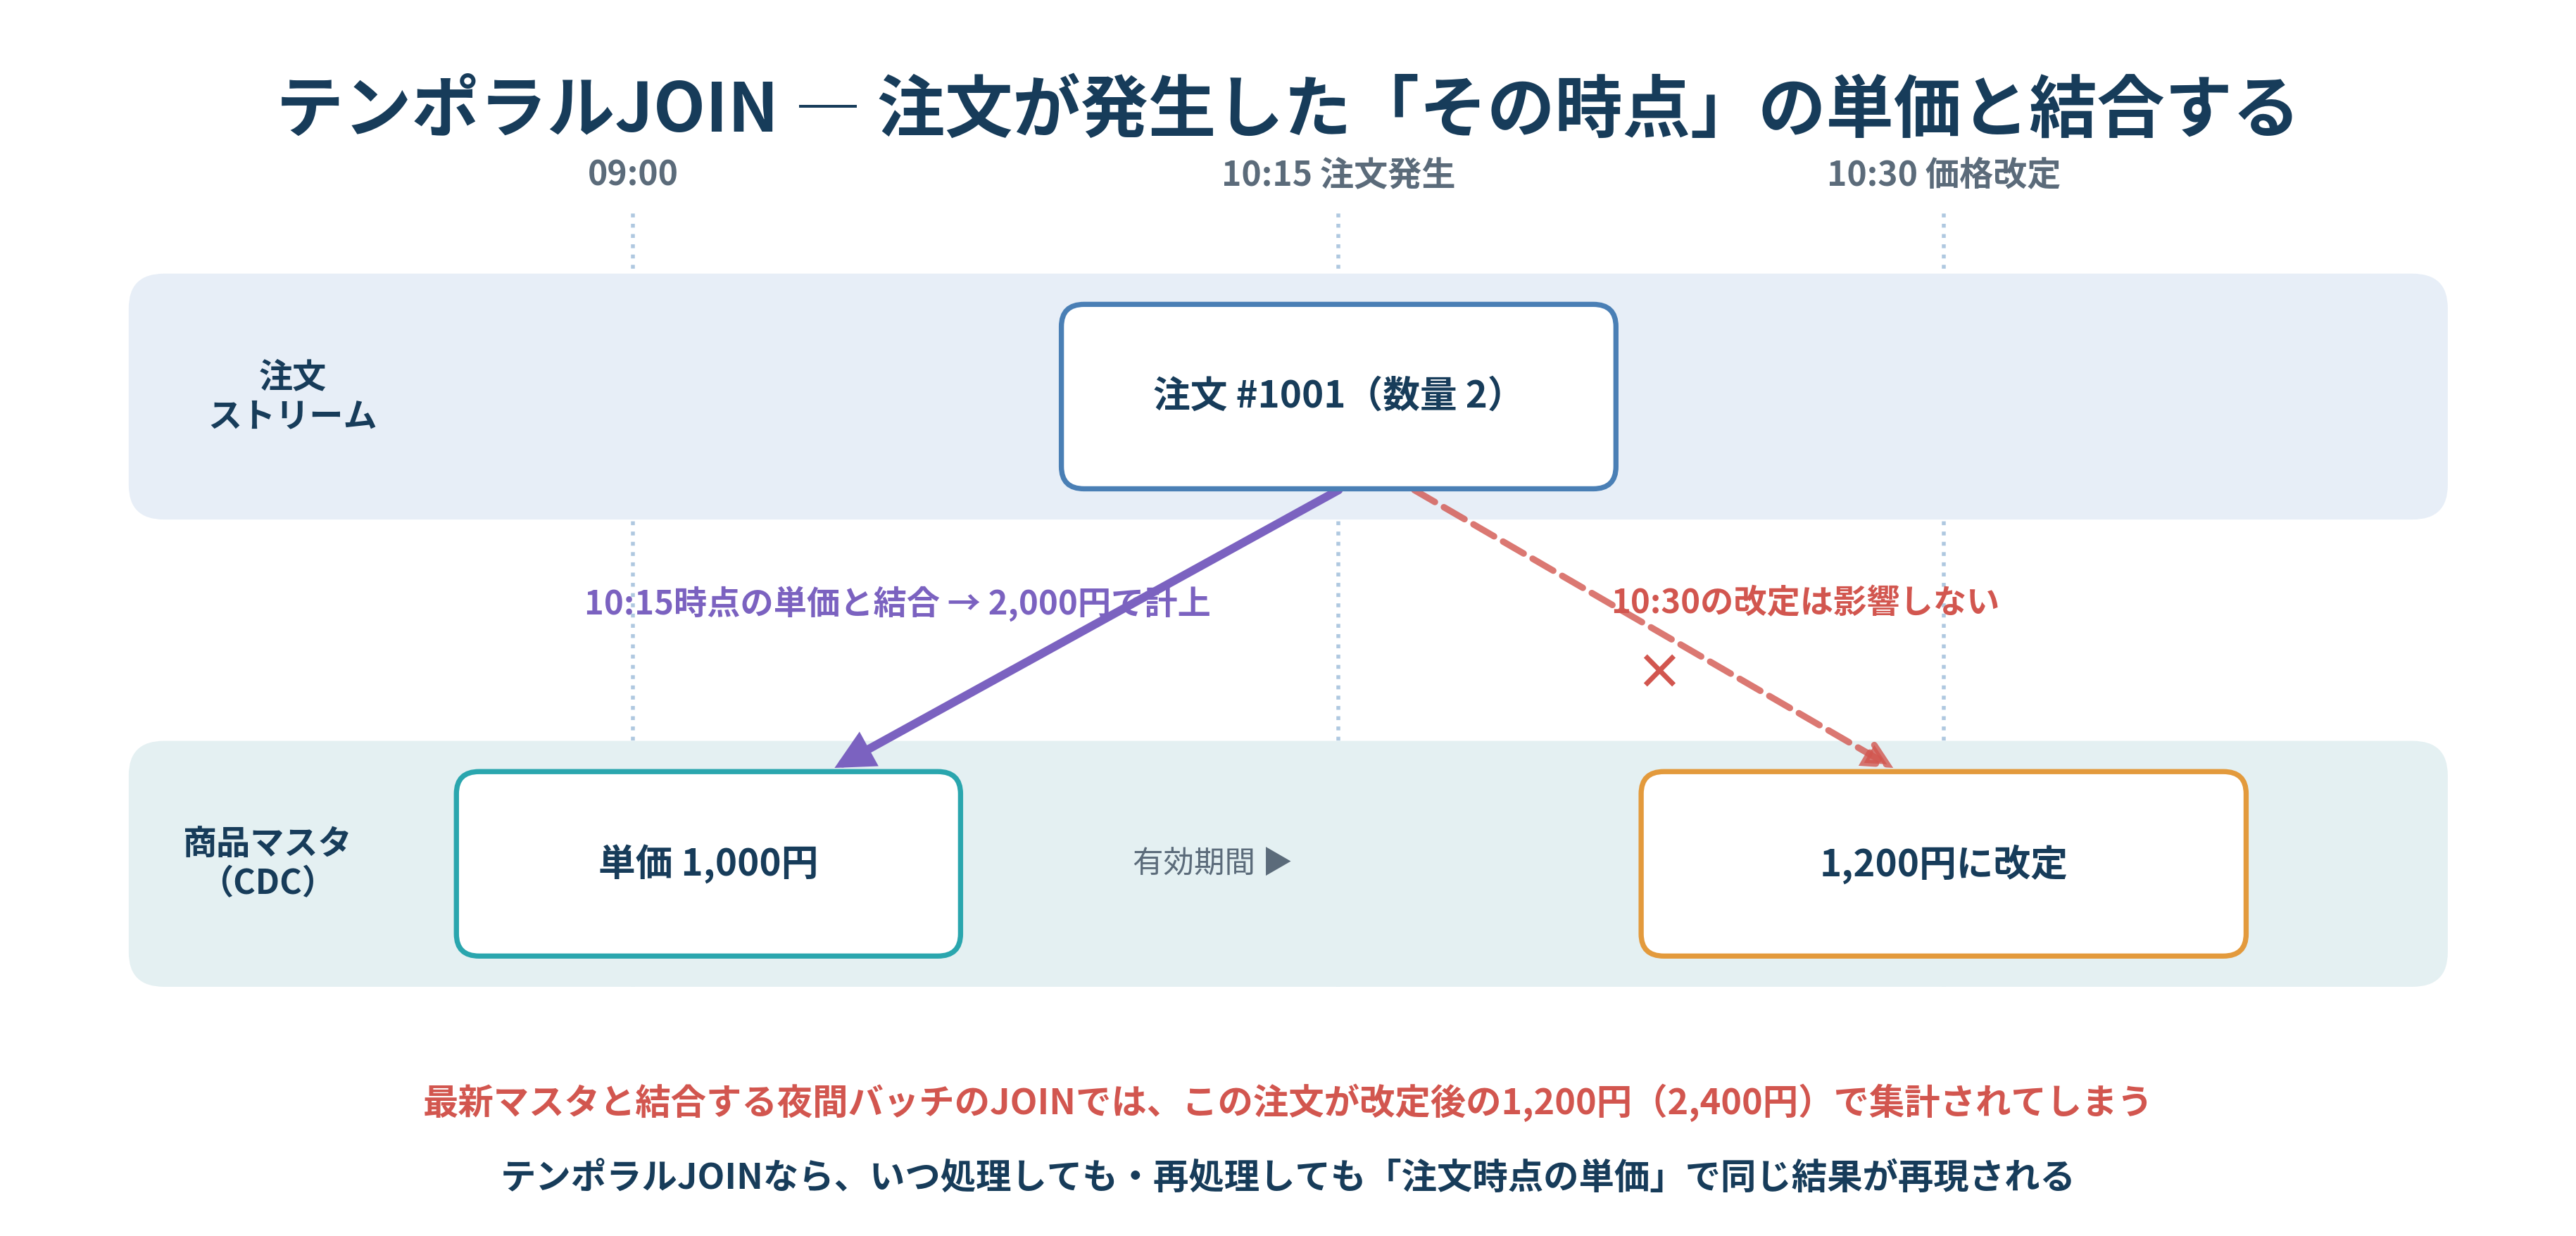
図6:テンポラルJOINの動き ― 注文が発生した「その時点」の単価と結合される
ここでのポイントは、「リアルタイムに処理しているのだから当然」ではない、という点です。比較対象は夜間バッチのJOINです。日次バッチでは実行時点(深夜)の最新マスタと結合されるため、図6の例では10:15の注文が、10:30に改定された後の単価1,200円で集計されてしまいます。ストリーム処理であっても、単純に「今のマスタ」と結合する方式では同じ問題が起きます。
テンポラルJOINの価値は、処理をいつ実行しても、障害後に再処理しても、常に「注文が発生した時点の状態」で結合され、同じ結果が再現されることにあります。マスタの変更履歴テーブルを自前で設計・管理する必要もありません。価格改定、為替レート、キャンペーン適用のように「いつ時点の値か」が金額に直結するデータで特に効果を発揮します。前回ご紹介したDebezium × Kafka × Databricksの構成に対して、Flinkを間に挟むことで「取り込む前に整えてから書き込む」ことが可能になります。
生成AIや機械学習の活用では、モデルそのものと同じくらい「モデルに渡すデータの鮮度」が結果を左右します。Flinkとの組み合わせ方は大きく2つあります。1つはAIが参照するデータを最新に保つ「リアルタイムRAG」、もう1つはストリームの中でモデルを呼び出す「リアルタイム推論」です。順に見ていきます。
生成AI(LLM)を活用した社内検索やカスタマーサポートでは、RAG(Retrieval-Augmented Generation)の仕組みでベクトルデータベースを参照させるのが一般的です。ここでベクトルDBへの同期が日次バッチになっていると、「最新の在庫状況」「直近の契約変更」「今発生している障害情報」が反映されず、AIが自信を持って古い情報を答えてしまいます。RAGの精度問題が、実はデータ同期の遅れに起因しているケースは少なくありません。
Flinkを挟むことで、基幹システムやCRMの変更データ(CDC)をKafka経由で受け取り、テキストのクレンジングや個人情報・機密情報のマスキング、他テーブルからのエンリッチメントまでを流れの中で実施できます。さらにConfluent Cloud for Apache Flinkでは、AIモデルをテーブルや関数と同じ「リソース」としてSQLに登録でき、ストリーム処理の中から直接呼び出してベクトル化できます。
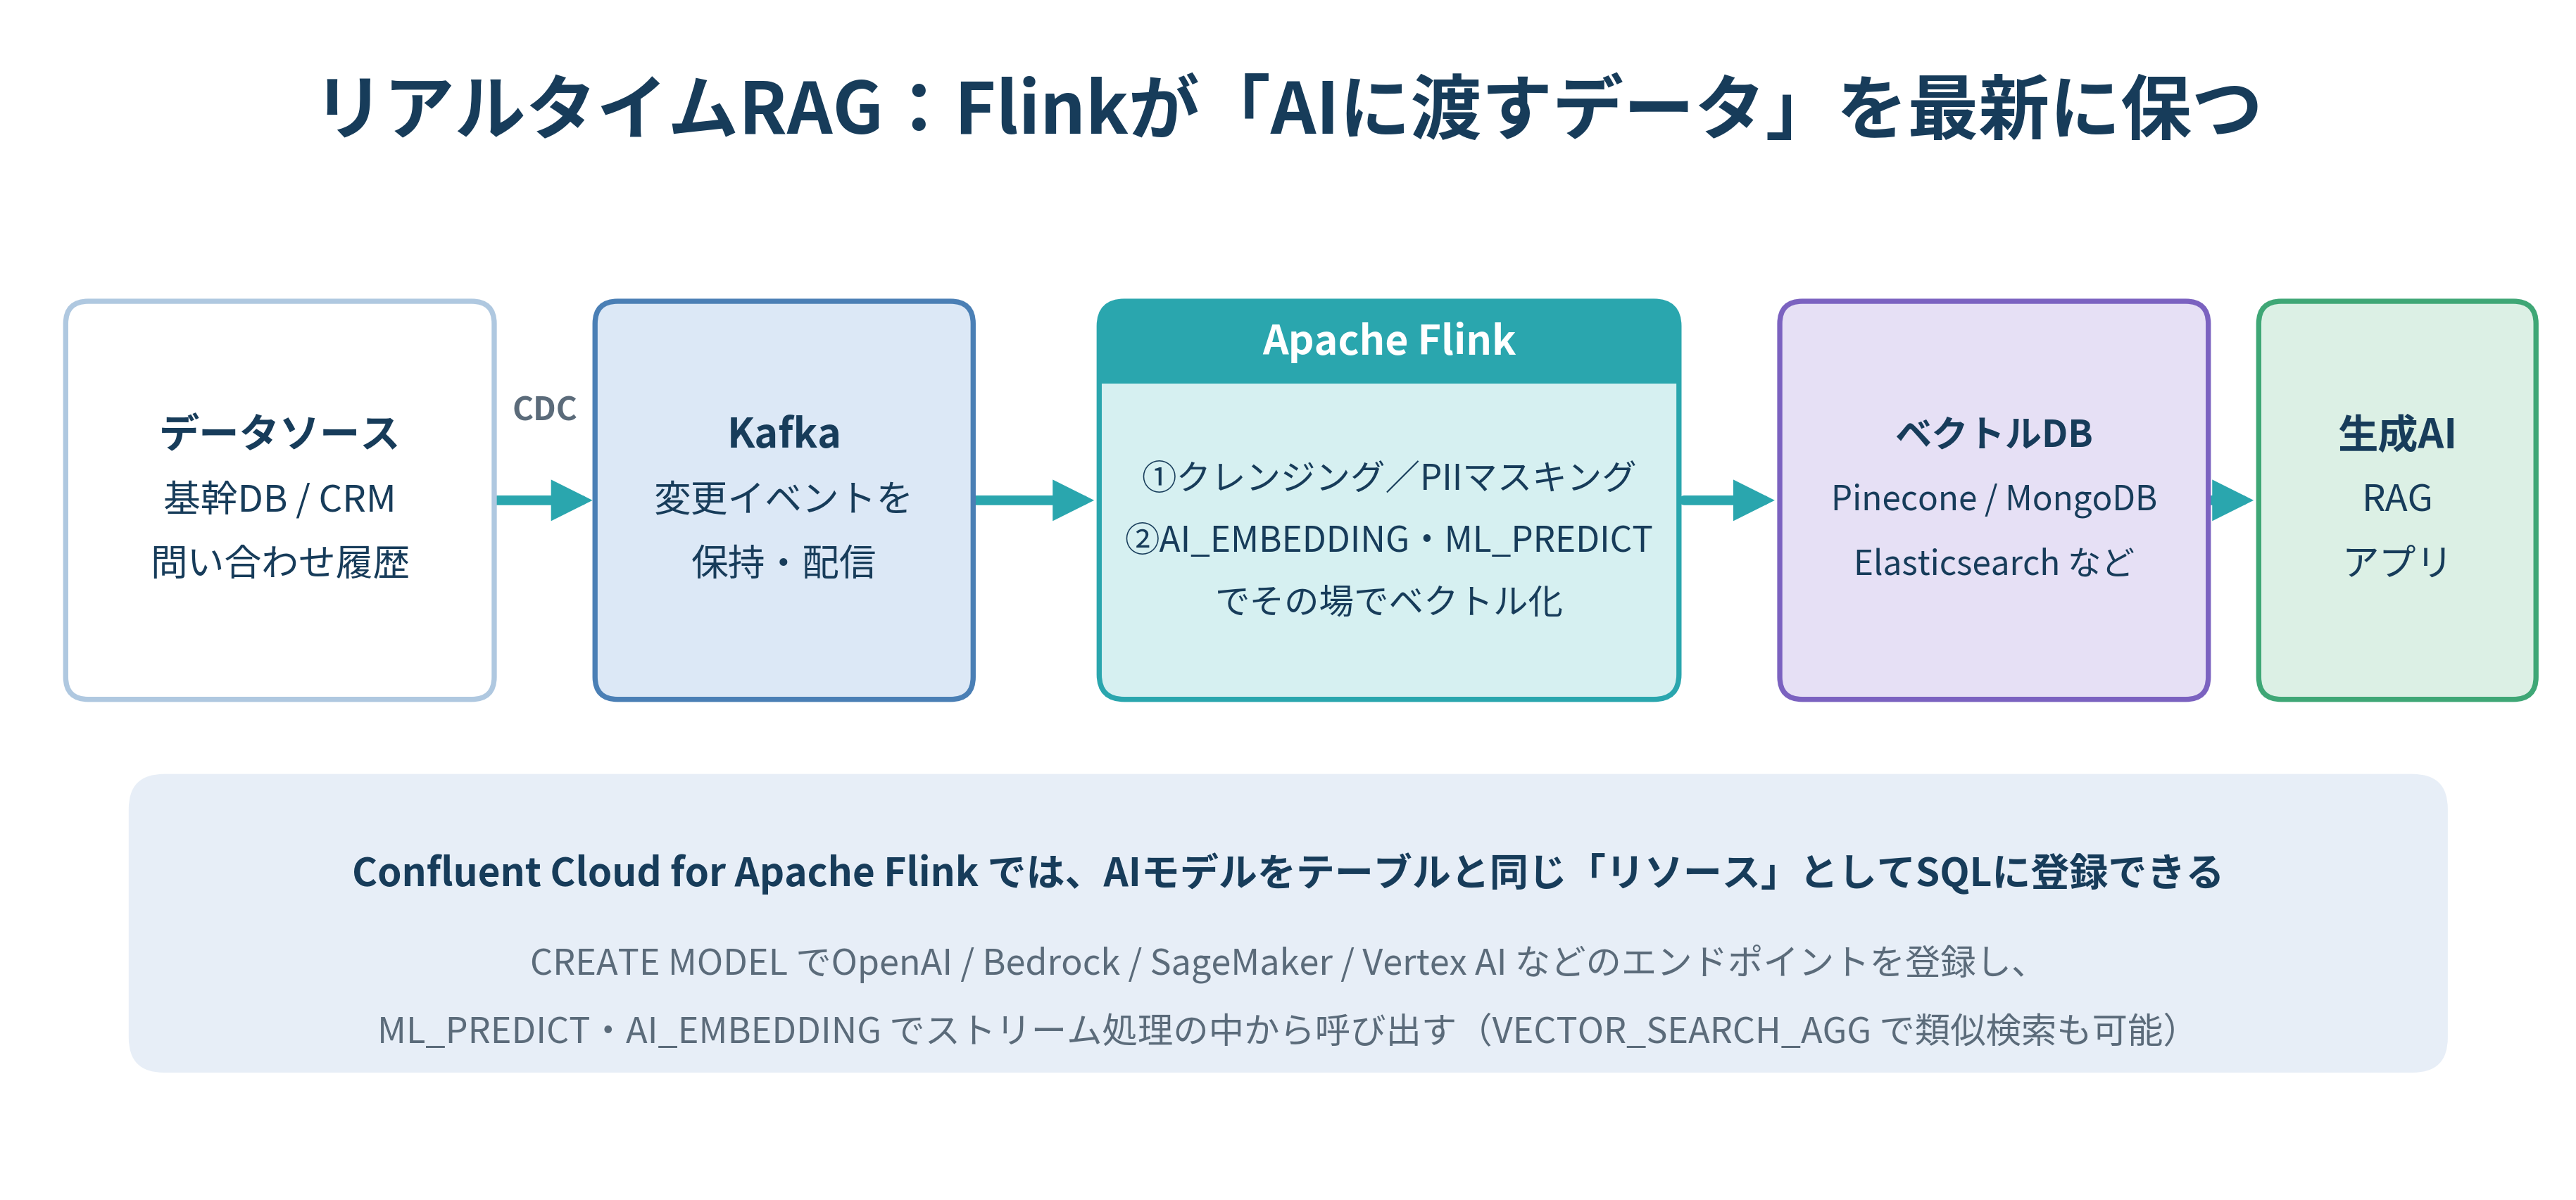
図7:リアルタイムRAG ― Flinkが「AIに渡すデータ」を最新に保つ
実際のFlink SQLは、次のような形になります。
-- ① 埋め込みモデルをリソースとして登録する(Azure OpenAIの例)
CREATE MODEL embedding_model
INPUT  (text STRING)
OUTPUT (embedding ARRAY<FLOAT>)
WITH (
	'provider' = 'azureopenai',
	'azureopenai.connection' = 'azureopenai-connection',
	'task'     = 'embedding'
);
-- ② CDCで流れてきた問い合わせ内容をマスキングし、その場でベクトル化する
INSERT INTO inquiry_embeddings
SELECT t.customer_id, t.cleaned_text, embedding, t.event_time
FROM (
	SELECT
		customer_id,
		MASK_PII(inquiry_text) AS cleaned_text,  -- 独自UDFでマスキング
		event_time
	FROM crm_inquiry_stream                      -- CDCコネクタの出力トピック
) AS t,
LATERAL TABLE(ML_PREDICT('embedding_model', t.cleaned_text));
生成されたベクトルはPineconeやMongoDB Atlas、Elasticsearchなどのベクトルデータベースへストリーミング書き込みします。ポイントは、マスキングとベクトル化が同じパイプラインの中で完結することです。個人情報を含んだままベクトル化してしまう事故を、処理の流れそのもので防げます。
もう1つの組み合わせ方が「リアルタイム推論」です。ECでのクリックや金融取引といったユーザーの行動に対して、「直近1分間の行動回数」「平均単価との乖離」といった特徴量をFlinkのステート機能でリアルタイムに算出し、上記と同じML_PREDICTで、SageMakerやBedrock、Vertex AIなどにホストした推論モデルへ投入します。埋め込みモデルを不正スコアリングモデルに置き換えるだけで書き方は同じです。これにより、「今まさに実行されようとしている不正取引の即時ブロック」や「その瞬間の文脈に合わせたレコメンド」をストリーム処理の中で完結できます。
ユースケース1のルールベース判定と地続きである点も実務上の利点です。「まずルールベースで始め、特徴量が溜まってきたらAIモデルの推論に載せ替える」という段階的な発展が、同じFlink SQLの延長線上で行えます。
ここまでご紹介したとおり、Confluent × Flinkは非常に強力です。一方で、単にツールを導入するだけでは、運用コストの増大やシステム構成の複雑化を招きかねません。
Hybrid Cloud diでは、アセスメントからアーキテクチャ設計、PoC、構築・運用支援まで、一貫したご支援を行っています。
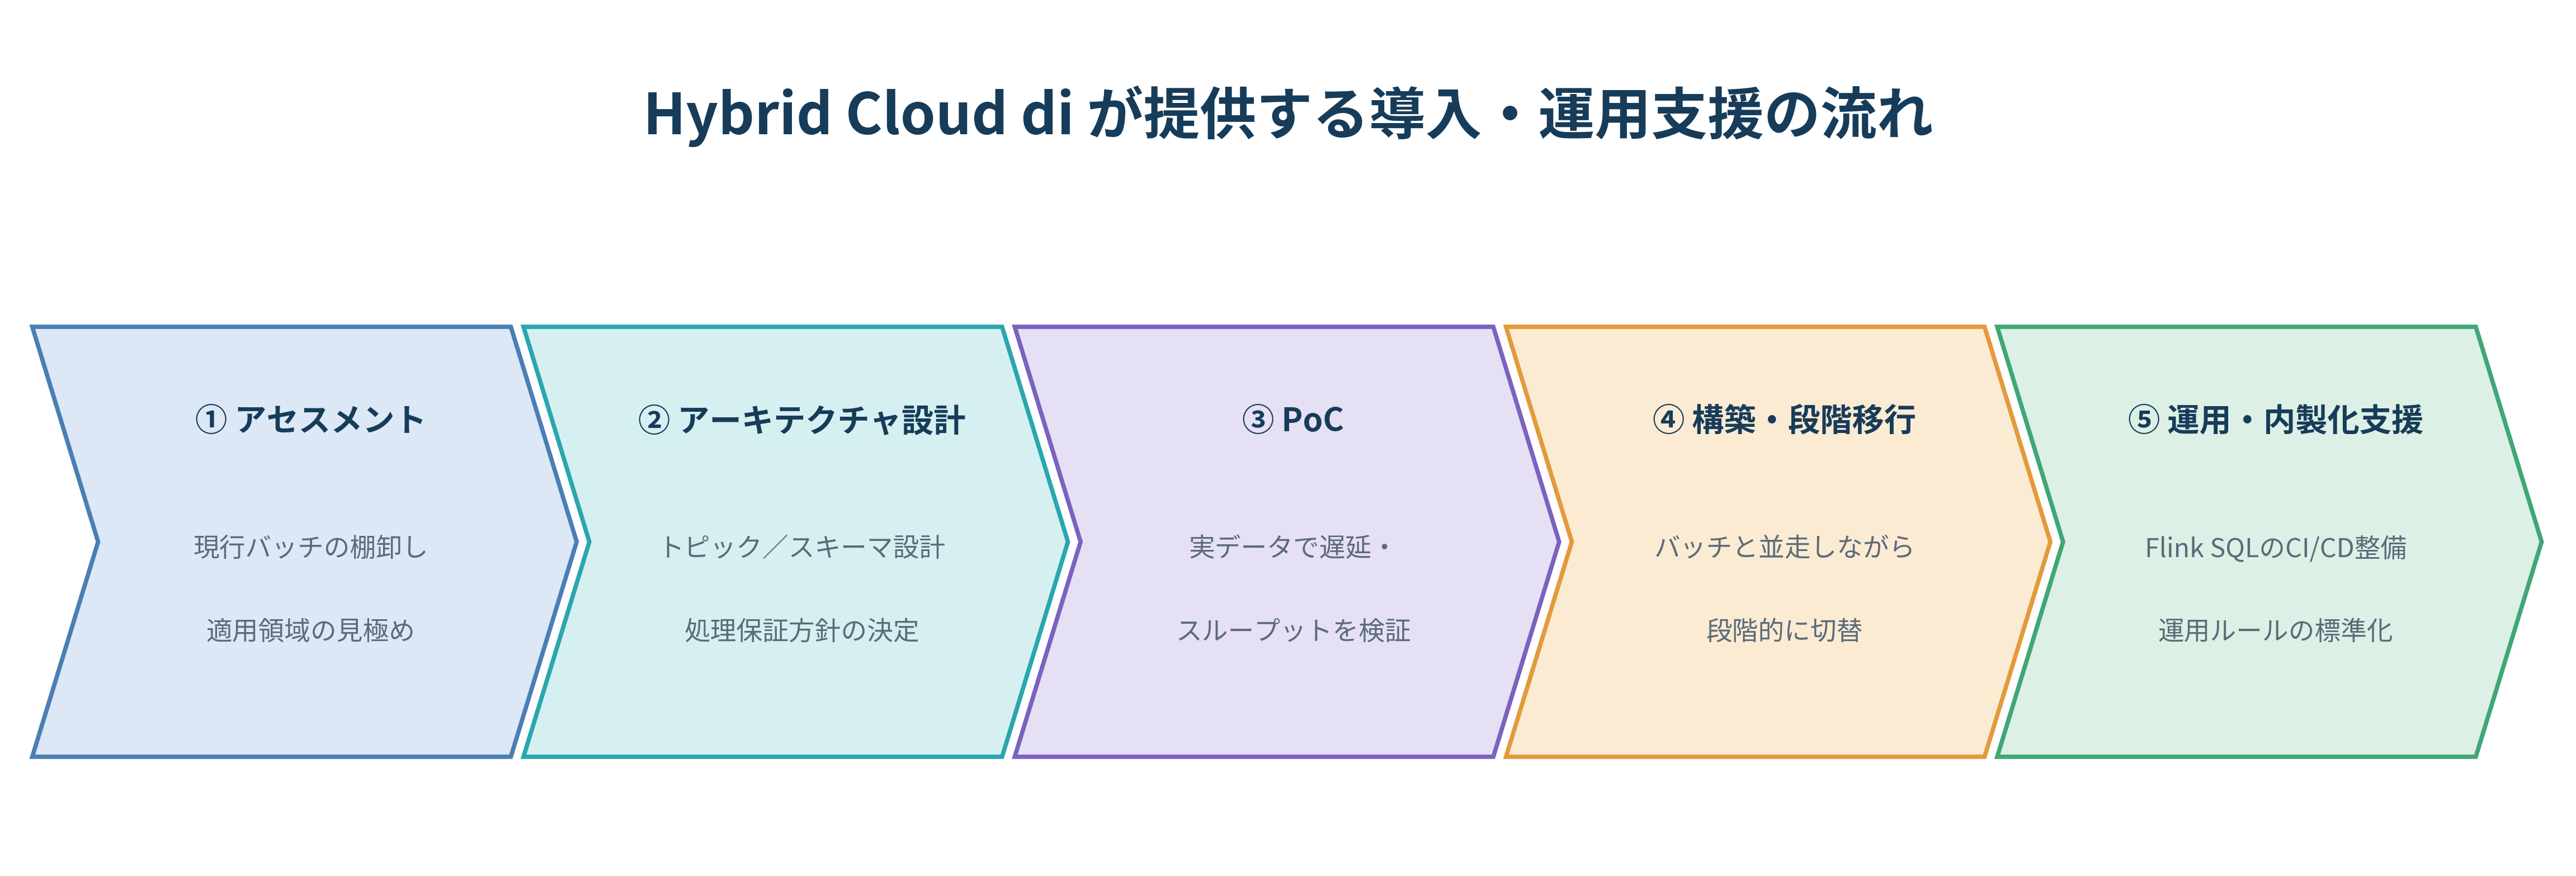
図8:Hybrid Cloud diが提供する導入・運用支援の流れ
弊社が特に重視しているのは、「あえてすべてをリアルタイム化しない」という判断です。日次で十分な処理までリアルタイムに置き換えると、コストと運用負荷だけが増えてしまいます。ビジネス上の効果が明確な領域から段階的に適用していくことが、リアルタイムデータ基盤を定着させる一番の近道だと考えています。
いかがでしたでしょうか。
今回はストリーム処理エンジンApache Flinkと、それをKafkaエコシステムと統合された形で提供するConfluentについてご紹介しました。ポイントを振り返ると、
前回までにお伝えしたKafkaの「止まらない、さばける、つなげる」、Debeziumの「見逃さない」に加えて、Flinkは「その場で考える」を実現します。
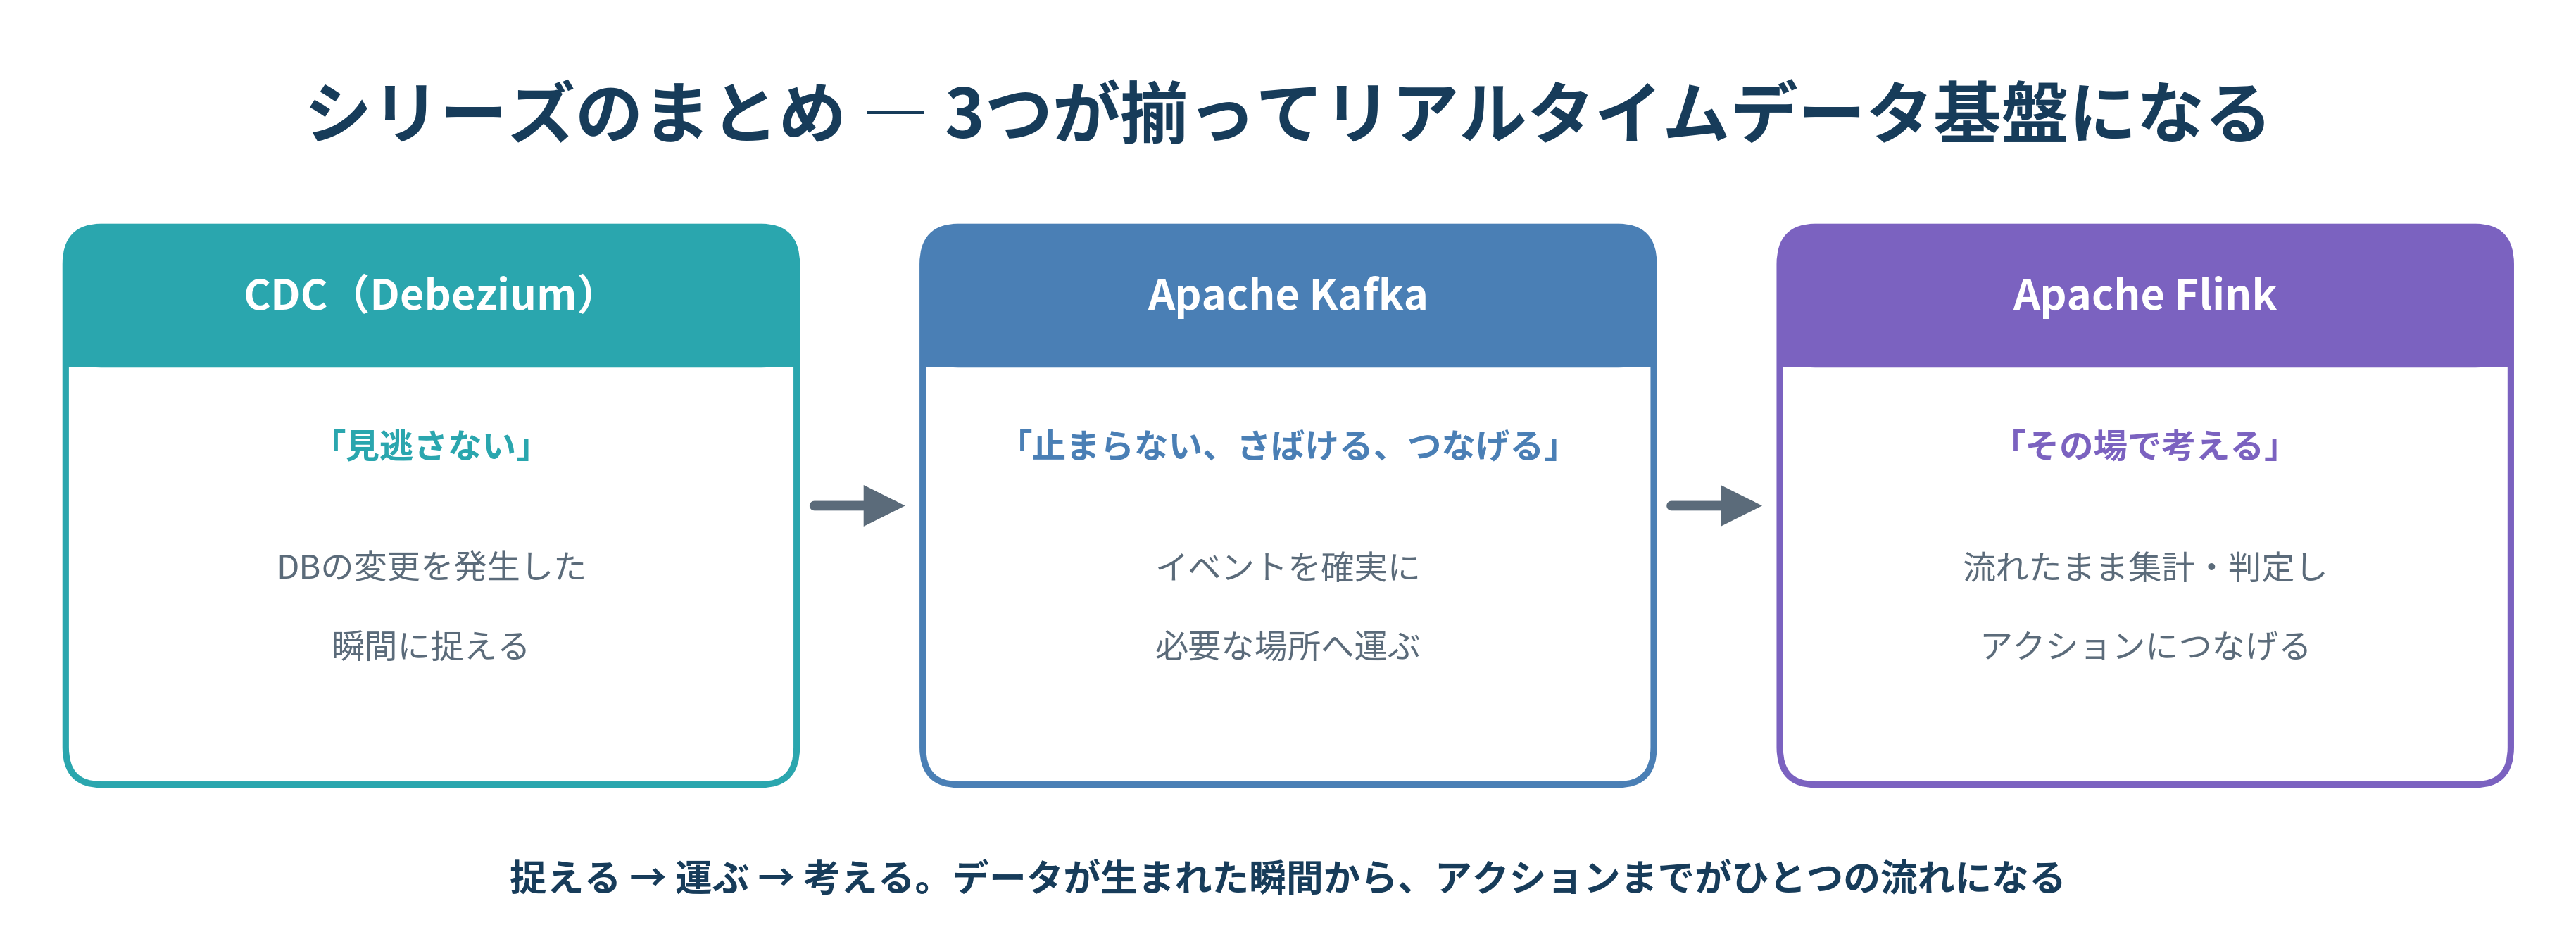
図9:シリーズのまとめ ― CDC・Kafka・Flinkの役割分担
データが生まれた瞬間に捉え、流れたまま判断し、必要なところへ届ける。この一連の流れが揃ってはじめて、リアルタイムデータ基盤は「使えるもの」になります。
「自社の既存システムにどうFlinkを組み込むべきか」「PoCでリアルタイム処理の実現性を検証したい」といったご要望がございましたら、ぜひお気軽にお問い合わせください。
次回以降も、Kafkaに関する技術トピックをお届けしてまいります。ぜひご覧いただけると嬉しいです。
記載されている製品/サービス名称、社名、ロゴマークなどは該当する各社の商標または登録商標です。
本ブログ記事は正確性を保証するものではなく、記事の内容によって生じた結果について、いかなる責任も負いません。